

对话中,需要帮助的时刻往往很尴尬:你已经在听对方说话,努力理解问题,同时回想原本想说的内容。如果旁边再来一个健谈的智能体,参与者增加了,清晰度却可能下降。
我正把 CallCoach 做成原生 macOS 原型。SwiftUI 界面把转写、脚本和提示放在一起。我需要一句能立刻说出口的简短回应。人在交谈时来不及阅读模型的解释。
对话分段到达
麦克风声音经过 AVAudioEngine,系统音频使用独立的 ScreenCaptureKit 路径。识别连接 Apple 的语音 API。文本更新随后进入提示层。
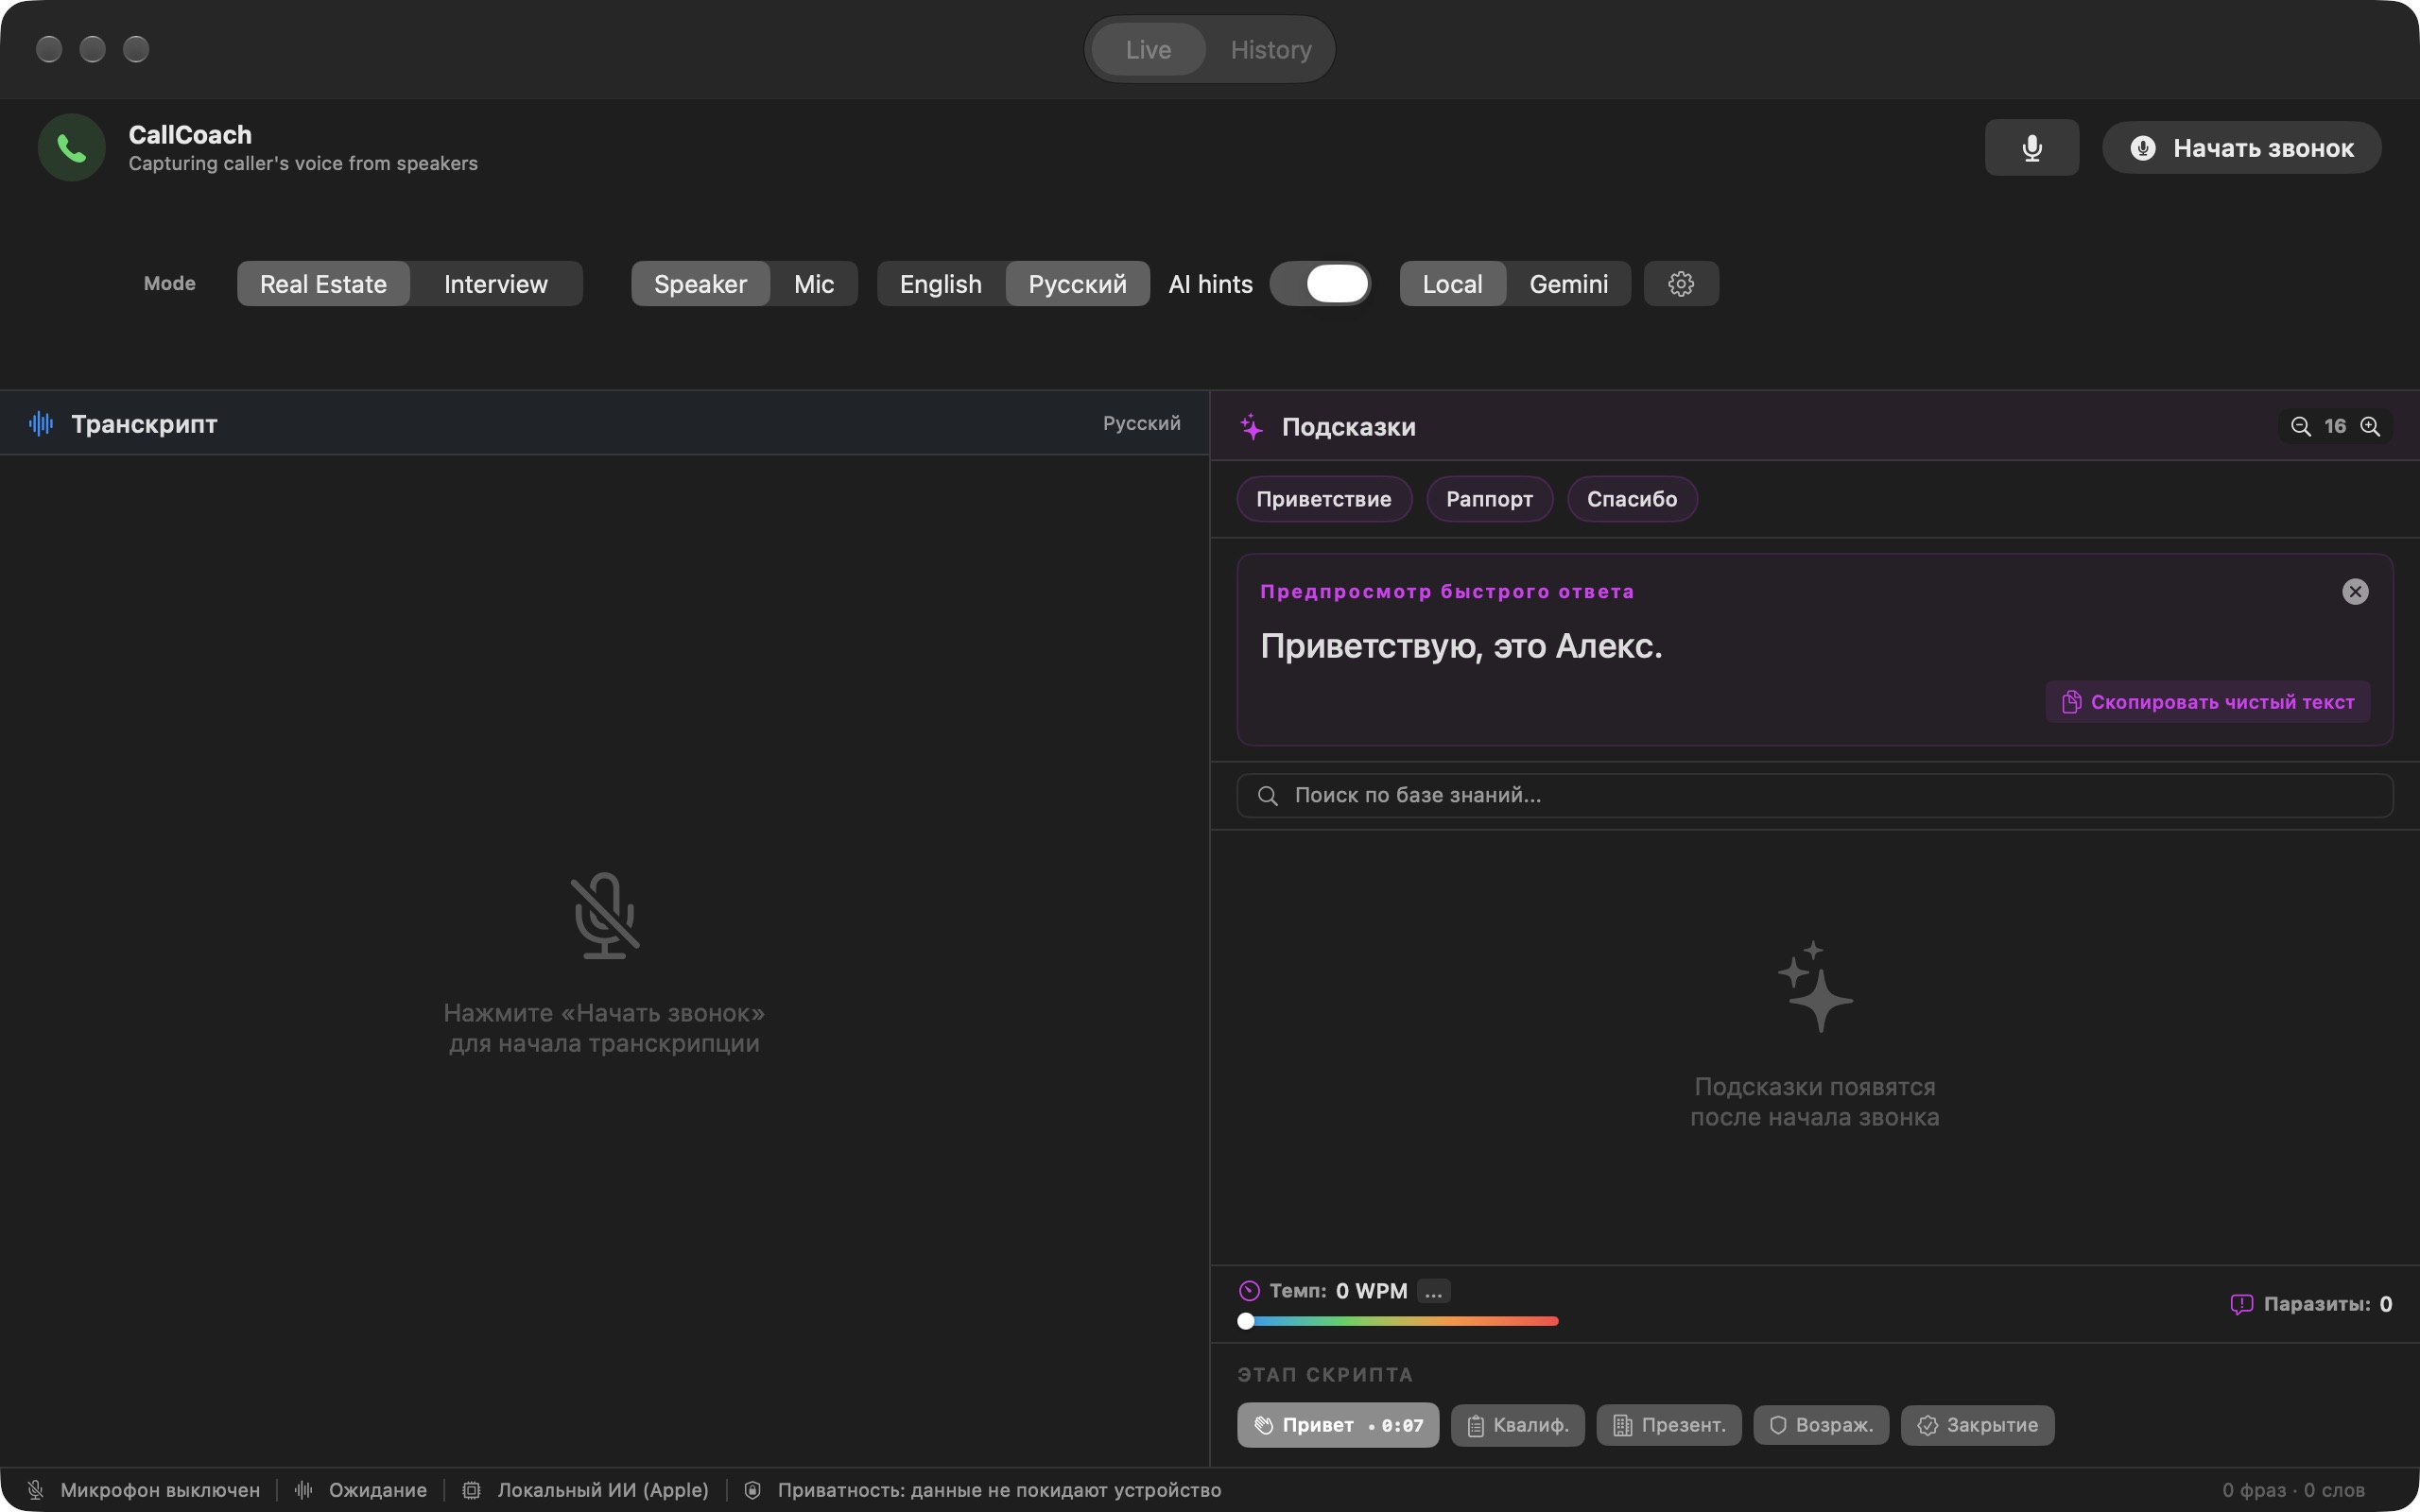
截图来自项目当前版本的 macOS CallCoach。打开的是 Real Estate 模式:左侧为转写区,右侧为快速回应和对话阶段。这里显示的是预备回应的预览;并未开始录音。
不能每识别出一个中间词,就触发新建议。当前代码用 450 毫秒延迟合并更新。这是处理参数,不是系统端到端延迟承诺:采集、识别和生成还各需时间。
上下文也有限制。知识库检索取最近的对话片段;发给模型的是最近一段词语,而不是无限延长的转写。否则,人们已经聊到完全不同的主题时,应用还会逐渐开始讨论通话开头。
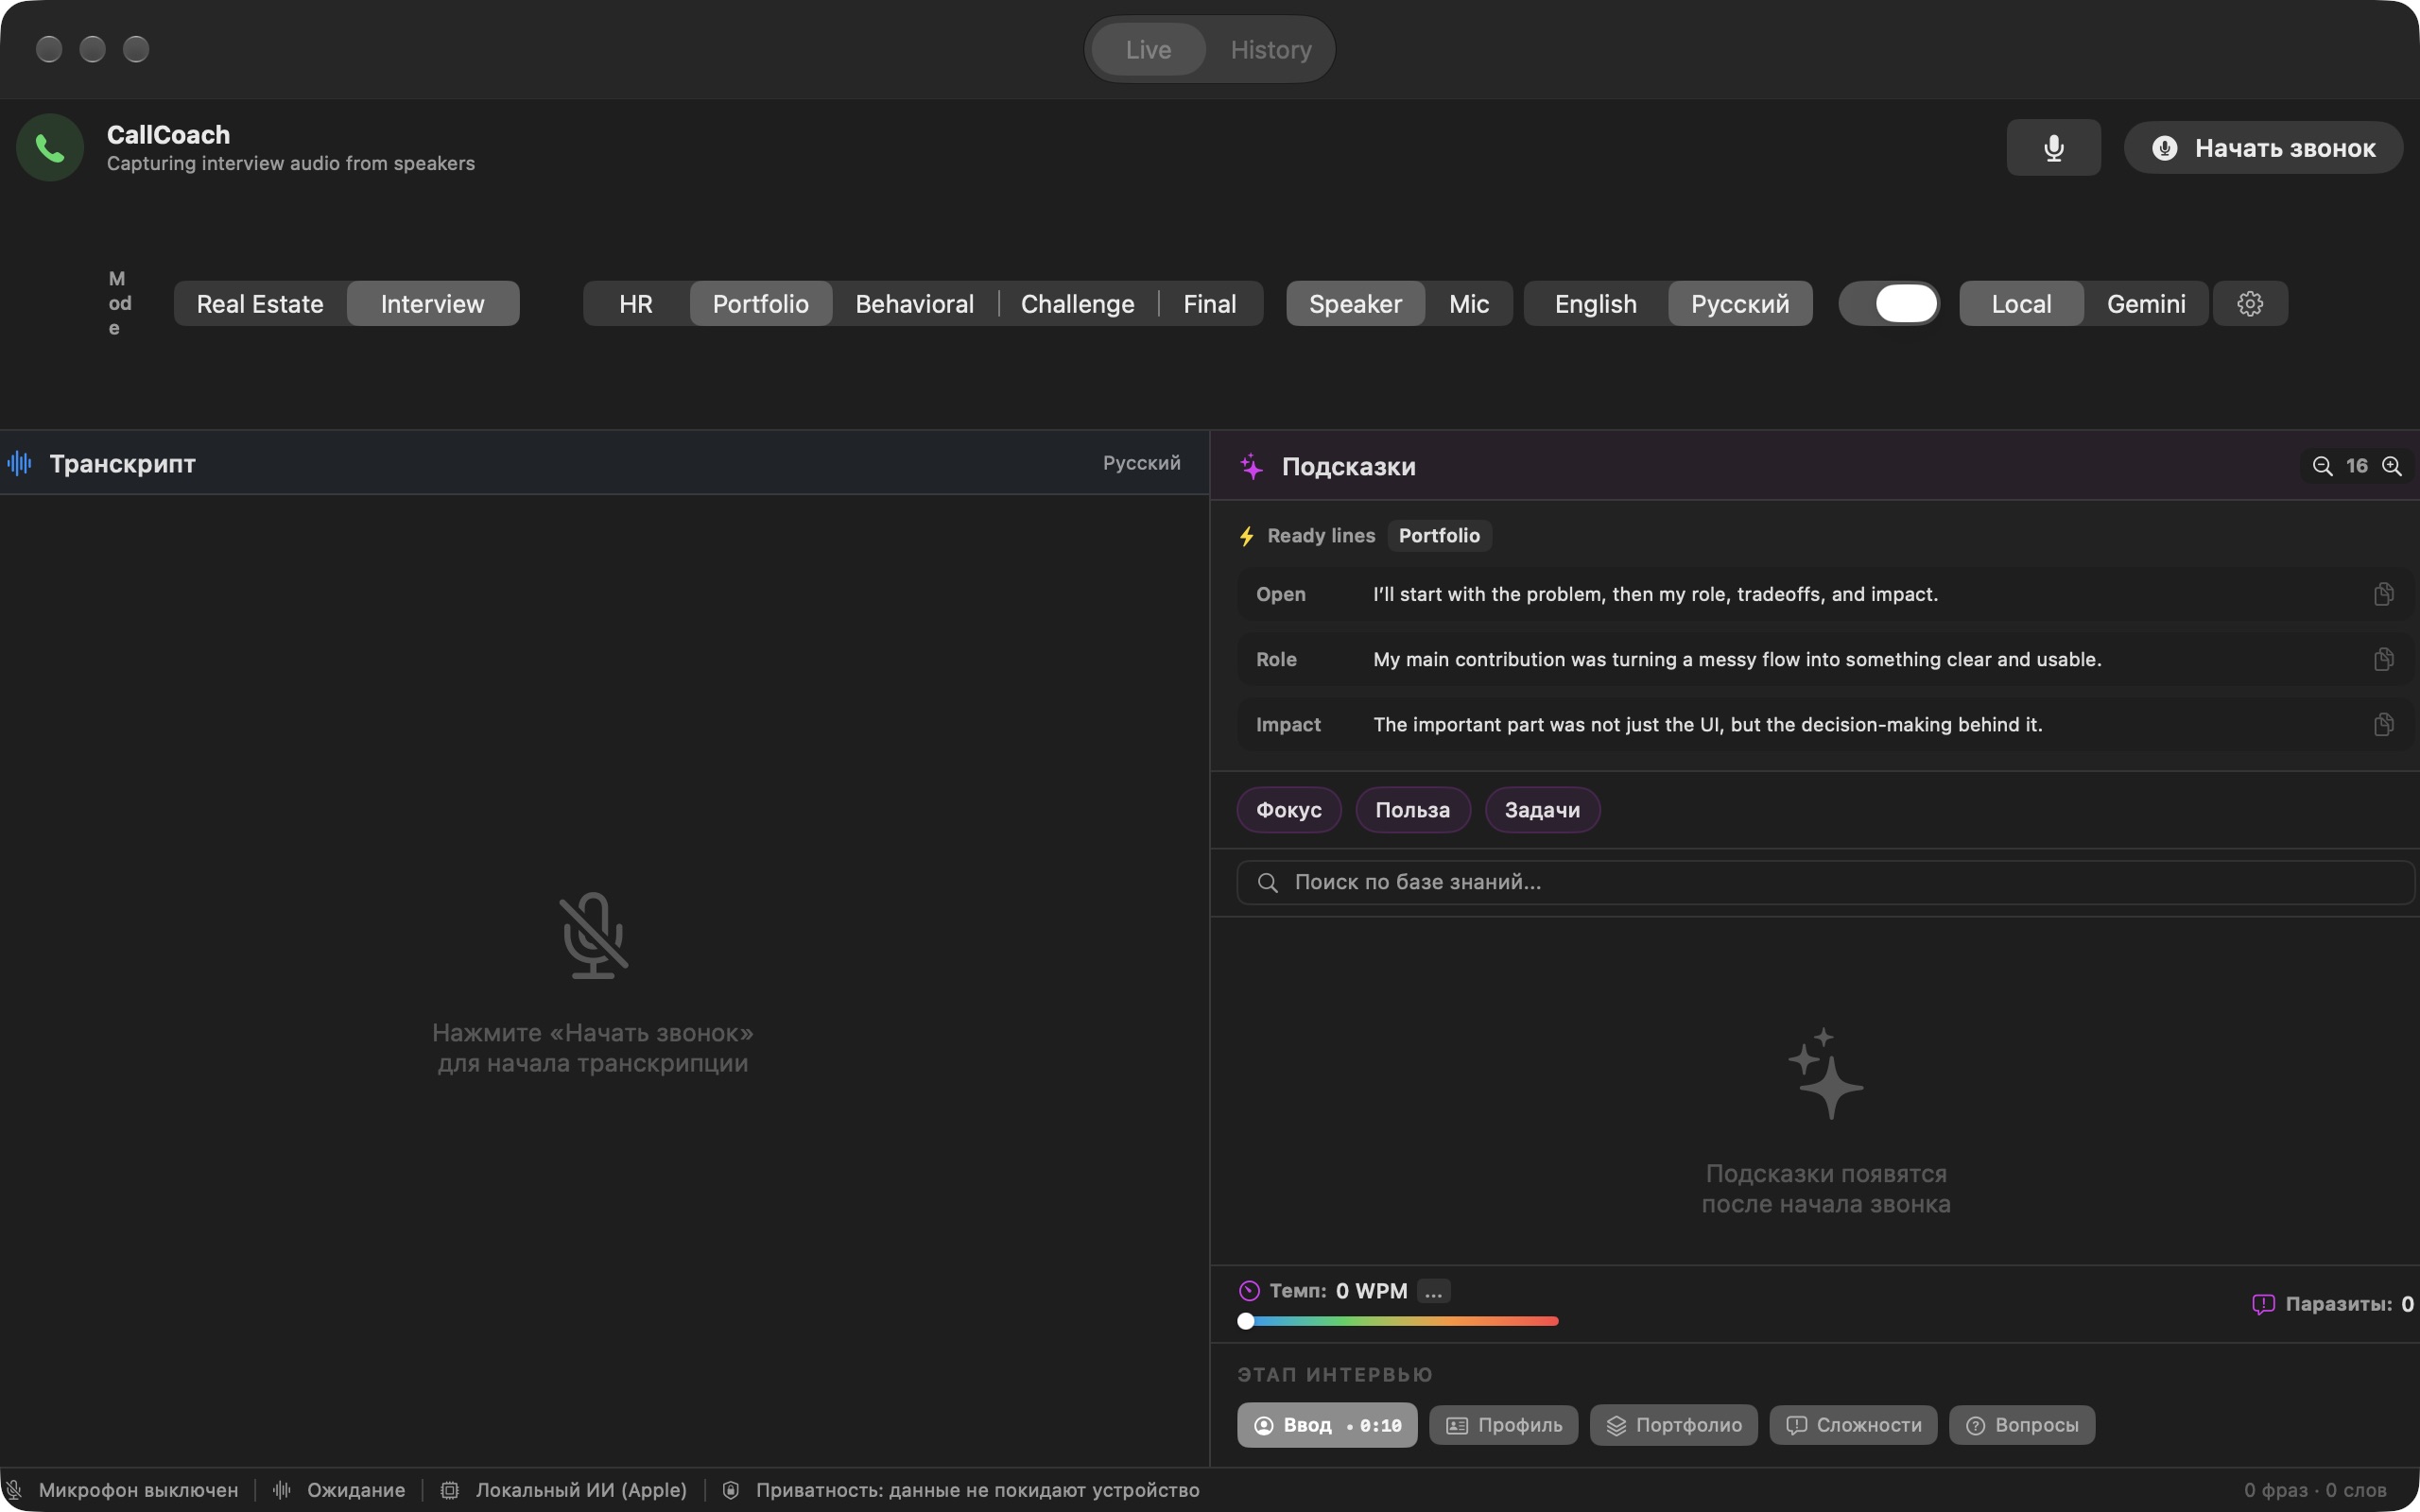
Interview 模式用同一界面帮助准备面试。屏幕选择了 Portfolio,可以看到介绍任务、个人角色和结果的简短预备措辞。这是真实应用窗口,没有录制对话。
“了解我的主题”不等于“我训练了模型”
项目包含对话场景、检查点和知识库相关片段检索。这是提供上下文与搜索,而非训练模型权重。区别很重要:新文档可能有助回答,但不会把系统变为经过验证的专家。
本地生成使用 Foundation Models,并检查设备是否可用。代码也包含可切换的 Gemini Live 云模式。云模式默认关闭,但选择它时,音频走另一条处理路线。因此,“所有内容永远留在 Mac 上”的承诺是不正确的。
最难的部分在屏幕上
提示即便正确,也可能碍事:出现太晚、重复显而易见的内容、遮住所需片段,或需要读太多文字。这必须在具体硬件上通过真实对话测试。代码仓库不能证明识别质量,也不能颁发优秀交谈者证书。
截图展示真实应用窗口及预备回应的预览。它们说明界面结构,而非真实对话中的识别质量。下一步要在具体硬件上验证简短提示是否及时、有用。
相关故事:对话式作品集。
@nevsky_alexander
在 Instagram,看明信片之外的迪拜:家人、城市、新发现,还有项目之间的日常。在 Threads,聊聊设计与 AI 的随想;在 YouTube,分享一条限时动态装不下的视频。选你习惯的平台关注,常来聊聊