
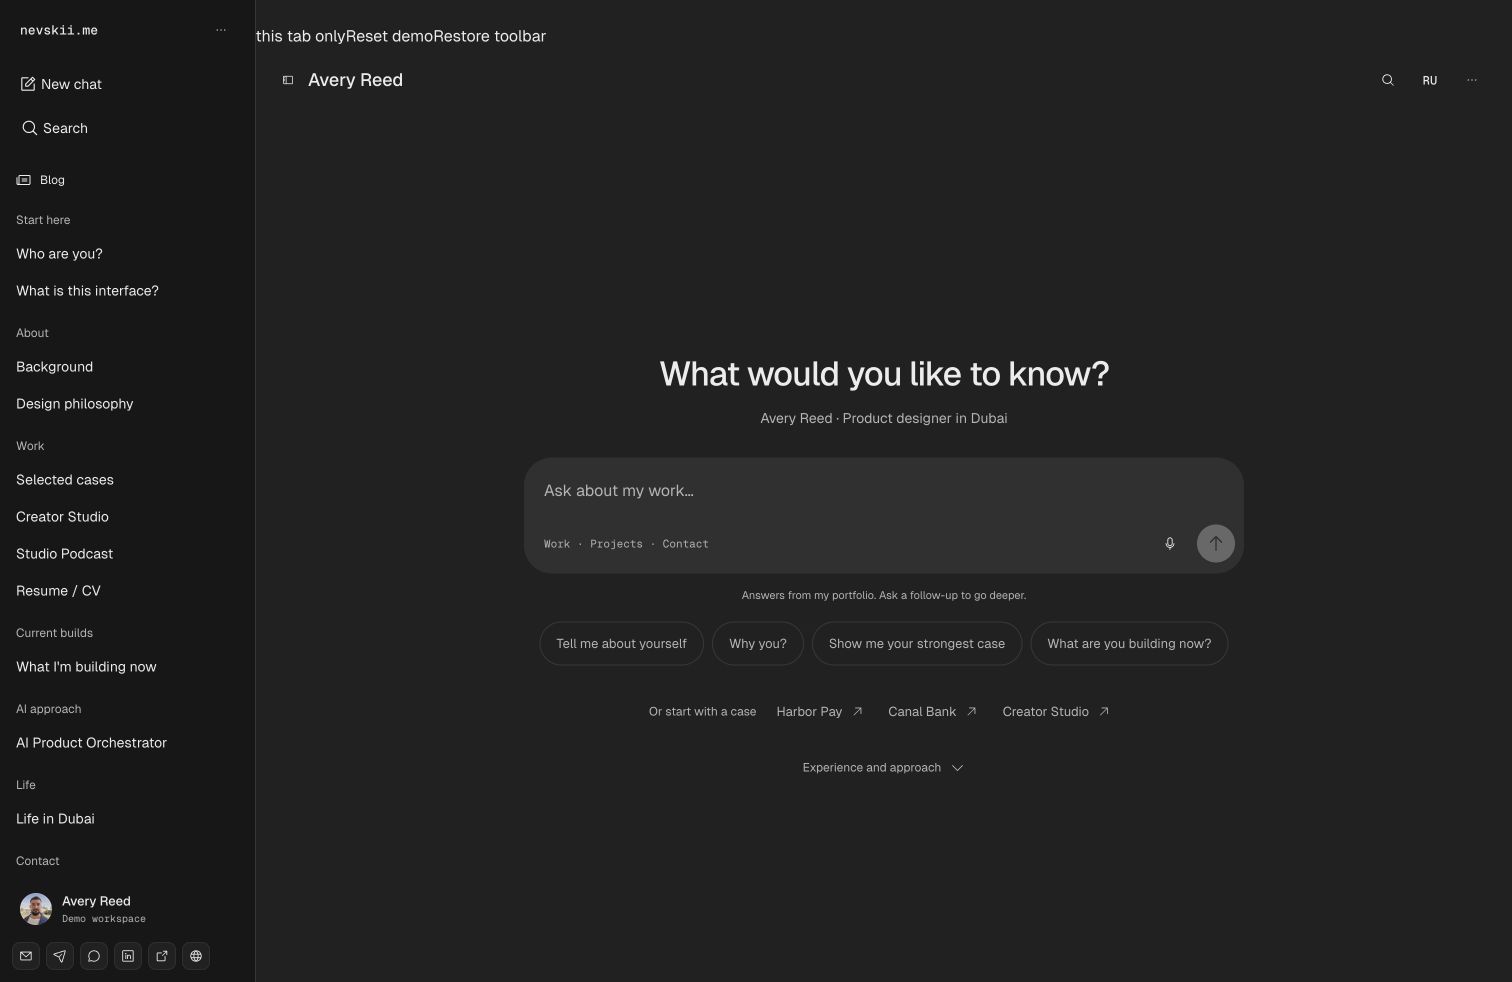
简历通常是一场庄重的独白。作者罗列自己认为重要的一切,读者则试图在日期、职位和团队合作的表述之间,找出自己问题的答案。
我试着颠倒顺序,让访客问自己需要的内容。有金融产品经验吗?在阿联酋做过什么?能看某个具体项目吗?这样的作品集像对话,但价值取决于它能否准确回到原始材料。
这是我的对话式简历的存档版本。它展示通过对话开始了解的方式;演示中的回答预先准备好了。
开始对话
归档界面 · 演示数据
先找到,再好好回答
项目有问题路由器:把查询与主题和项目匹配,考虑文本匹配和额外语义信号。直接进入主题或项目是确定性行为。自由提问则由当前配置通过 Workers AI 合成答案;生成不可用时,回到准备好的作者内容。
这里是关于专业经历的示例对话。可以尝试现有主题,查看原始界面如何引导预备回答,而不访问 AI 服务。
预备对话
归档界面 · 演示数据
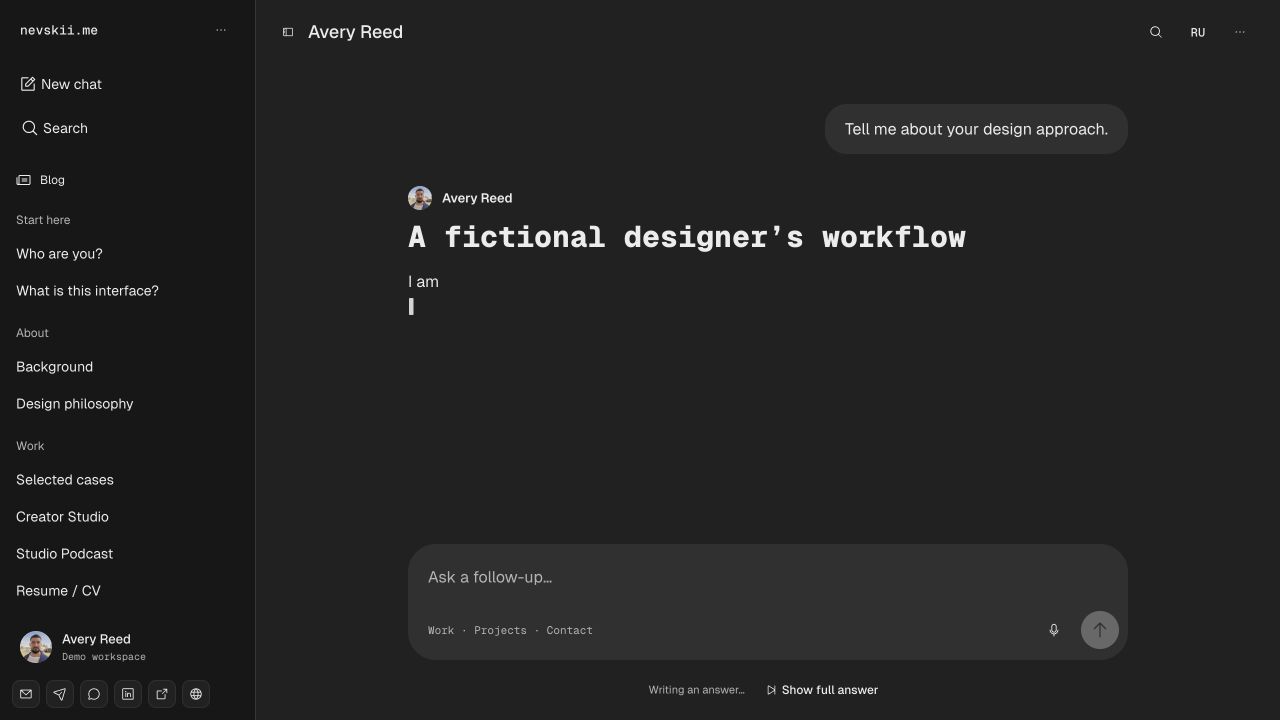
模型收到有限的材料片段和最近的对话历史。两者作用不同:历史帮助理解问题,而关于我经历的事实必须来自内容。访客刚称我为宇航员,不是把飞行写进传记的理由。
访客不用我的措辞时,语义检索很有用。“银行应用”和“金融科技”可能指向同一经历。但词语相近不能证明事实:如果对方问我是否领导过大型工程团队,不能找一个相近案例就悄悄给我升职。
因此,回答必须与检索到的内容关联。项目链接是答案的一部分,不是可有可无的装饰。匹配较弱时,追问澄清比从概率中拼出可信传记更好。
语音是另一个入口
语音改变提问方式,但不能改变允许使用的事实。识别之后,系统仍然要完成同样的任务:找到合适材料,并提供清楚的路径。
我把它看作实验性的作品集形式。代码里存在语义路由,不代表每个问题都能理解正确,也不代表访客更喜欢聊天而不是普通作品列表。这要观察人们如何使用。
不过,我喜欢这个方向。优秀作品集不必让所有人读同一篇自传。它可以根据人的兴趣解释经历,前提是健谈的界面背后仍有可核验的作者。
成果是进入作品集的另一种方式:访客提问,获得通往相关材料的路径。内嵌对话为演示预先准备。语音和实时生成的能力,需要与这些画面的质量分开验证。
相关故事:Source 与 Operator · 网站终端。
@nevsky_alexander
在 Instagram,看明信片之外的迪拜:家人、城市、新发现,还有项目之间的日常。在 Threads,聊聊设计与 AI 的随想;在 YouTube,分享一条限时动态装不下的视频。选你习惯的平台关注,常来聊聊