

Im Gespräch wird Hilfe im ungünstigsten Moment gebraucht: Man hört bereits zu, versucht die Frage zu verstehen und erinnert sich zugleich an das, was man sagen wollte. Eine weitere redselige Intelligenz erhöht vielleicht die Teilnehmerzahl, aber nicht die Klarheit.
Ich entwickle CallCoach als nativen macOS-Prototyp. Die SwiftUI-Oberfläche hält Transkript, Gesprächsleitfaden und Hinweis beieinander. Ich brauche einen kurzen Satz, den man sofort aussprechen kann. Während des Gesprächs bleibt keine Zeit für Modellerklärungen.
Gespräche kommen stückweise an
Mikrofonton läuft durch AVAudioEngine, Systemaudio nutzt einen eigenen Weg über ScreenCaptureKit. Die Erkennung verwendet Apples Sprach-APIs. Textaktualisierungen gelangen dann in die Hinweisschicht.
Der Screenshot zeigt CallCoach für macOS im aktuellen Projektstand. Real Estate ist geöffnet: links Platz für das Transkript, rechts schnelle Antworten und Gesprächsphasen. Zu sehen ist die Vorschau eines fertigen Satzes; eine Anrufaufnahme wurde nicht gestartet.
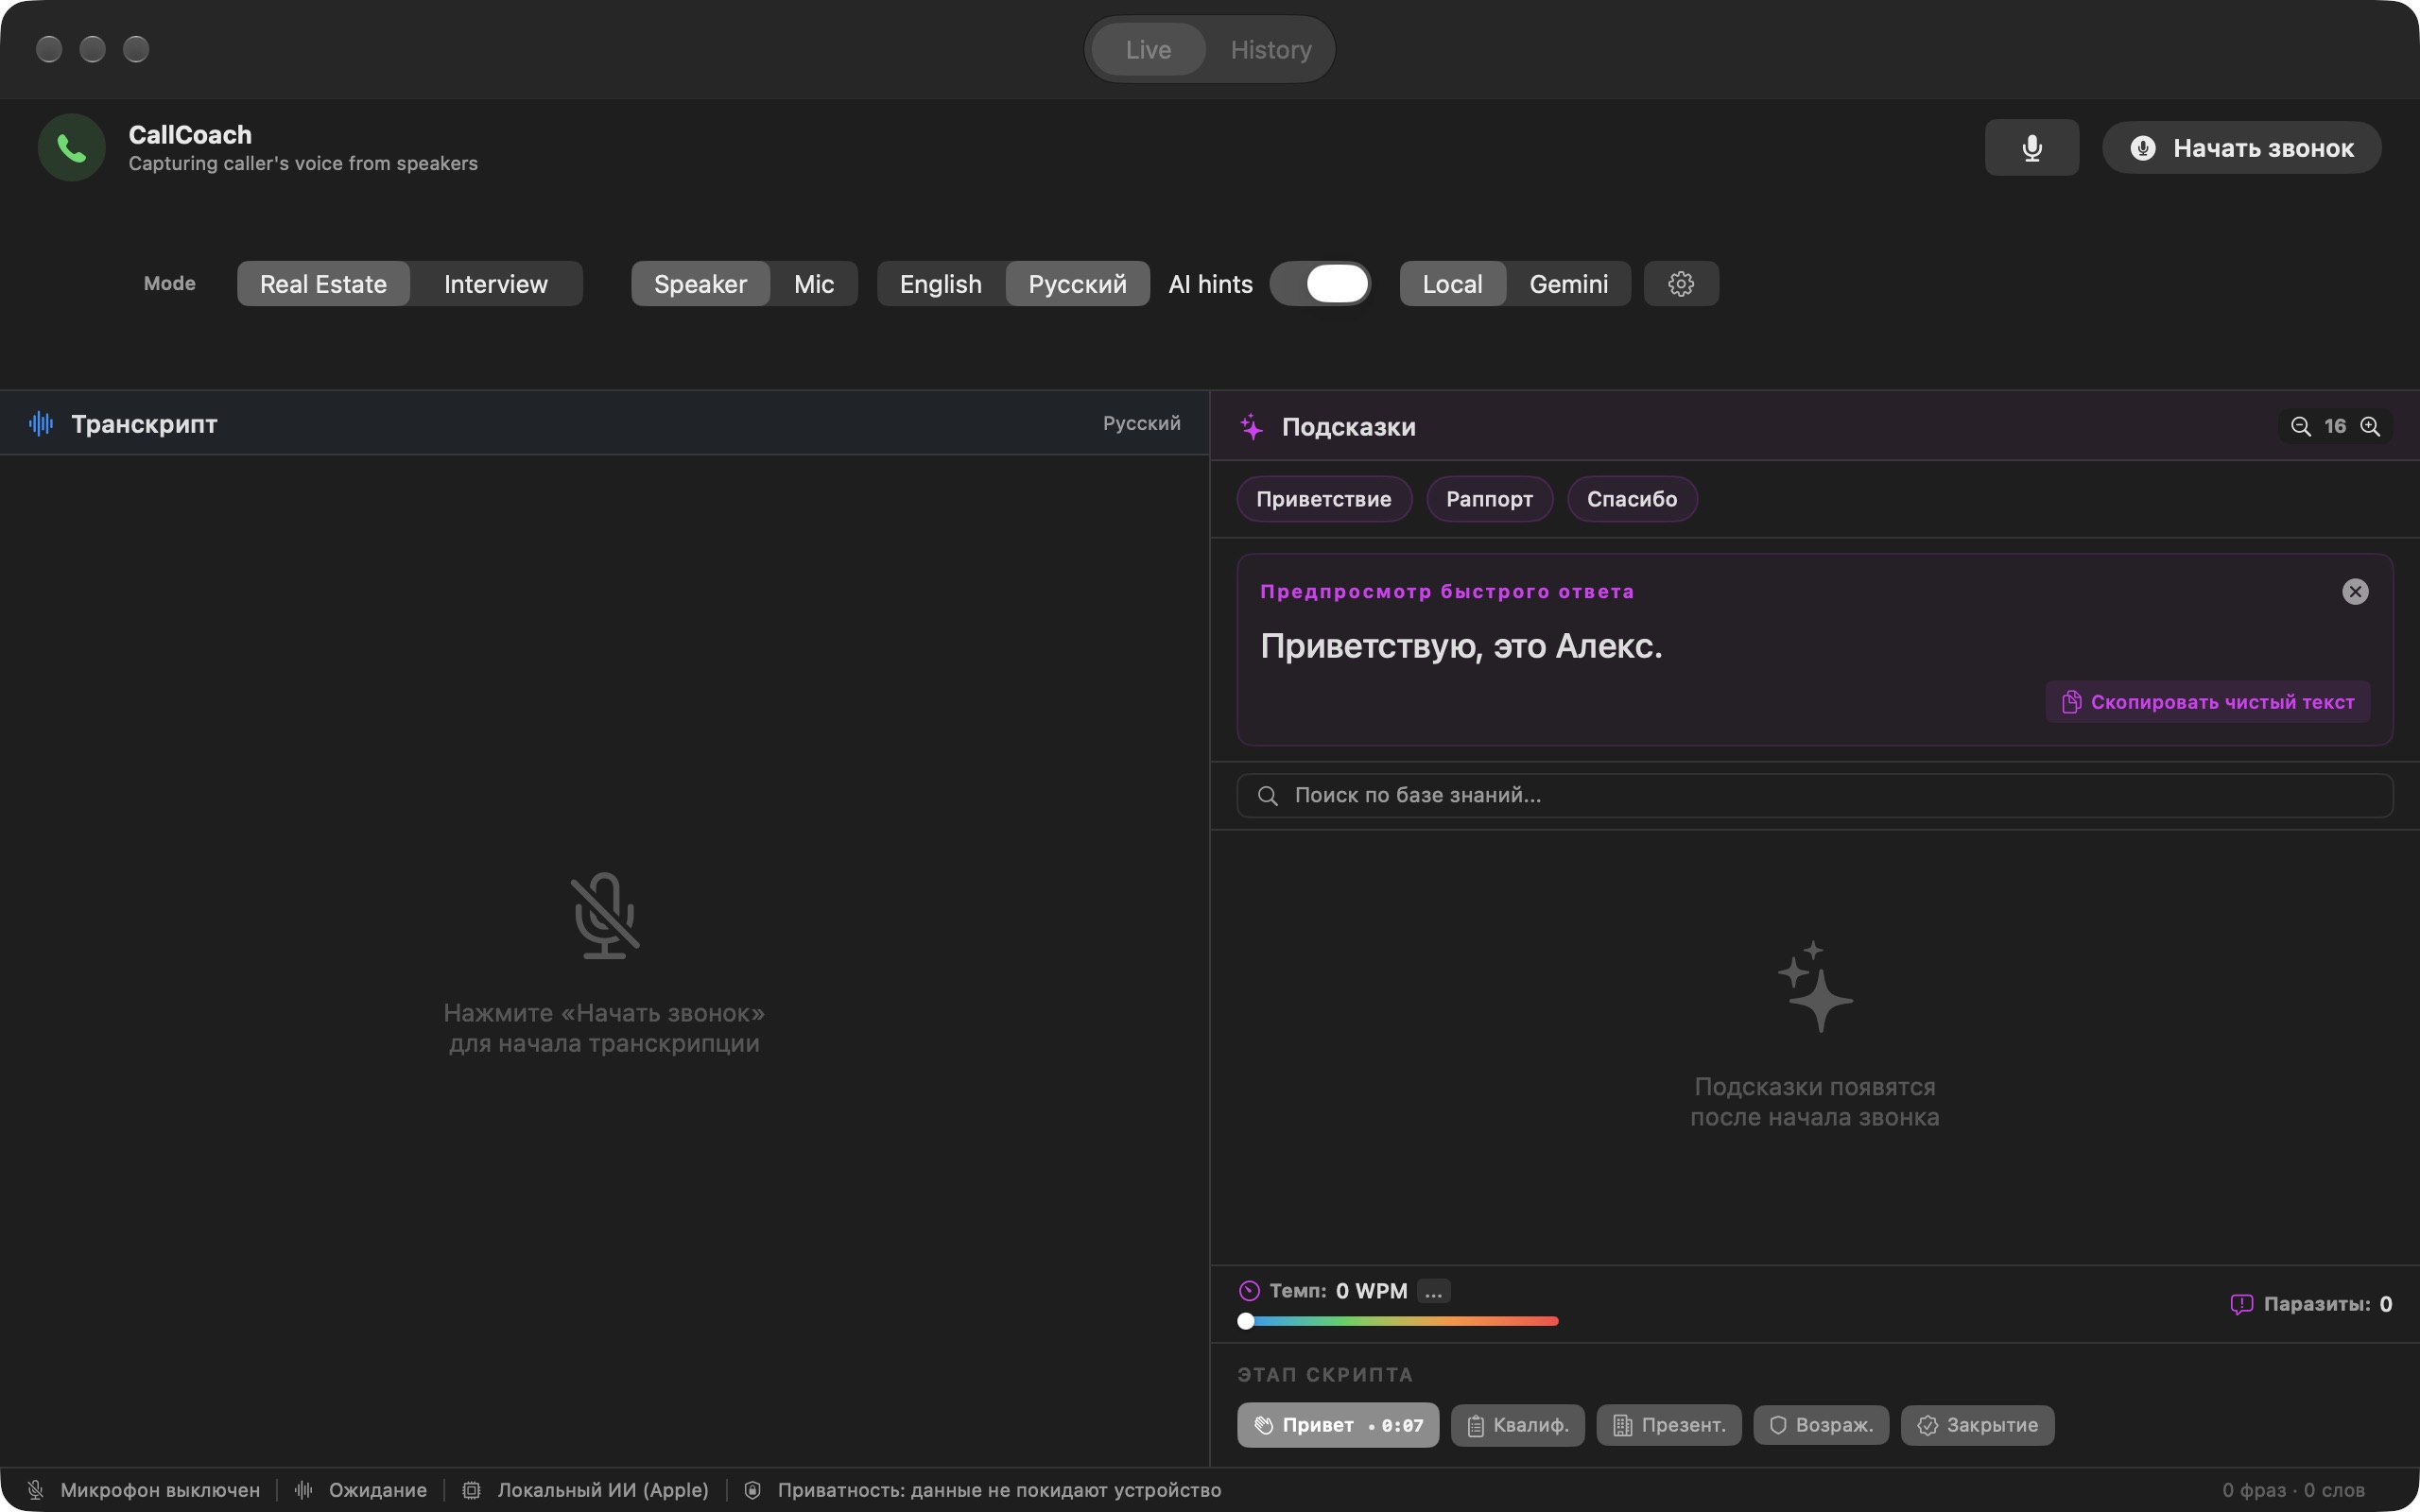
Nicht jedes vorläufige Wort darf eine neue Empfehlung auslösen. Der aktuelle Code bündelt Aktualisierungen mit 450 Millisekunden Verzögerung. Das ist ein Verarbeitungsparameter, kein Versprechen für die Gesamtlatenz: Aufnahme, Erkennung und Generierung brauchen zusätzlich Zeit.
Auch der Kontext ist begrenzt. Die Wissenssuche verwendet einen jüngeren Gesprächsausschnitt; die Modellanfrage erhält ein Fenster der letzten Wörter statt eines endlosen Transkripts. Sonst diskutiert die Anwendung irgendwann den Gesprächsanfang, obwohl die Menschen längst bei einem anderen Thema sind.
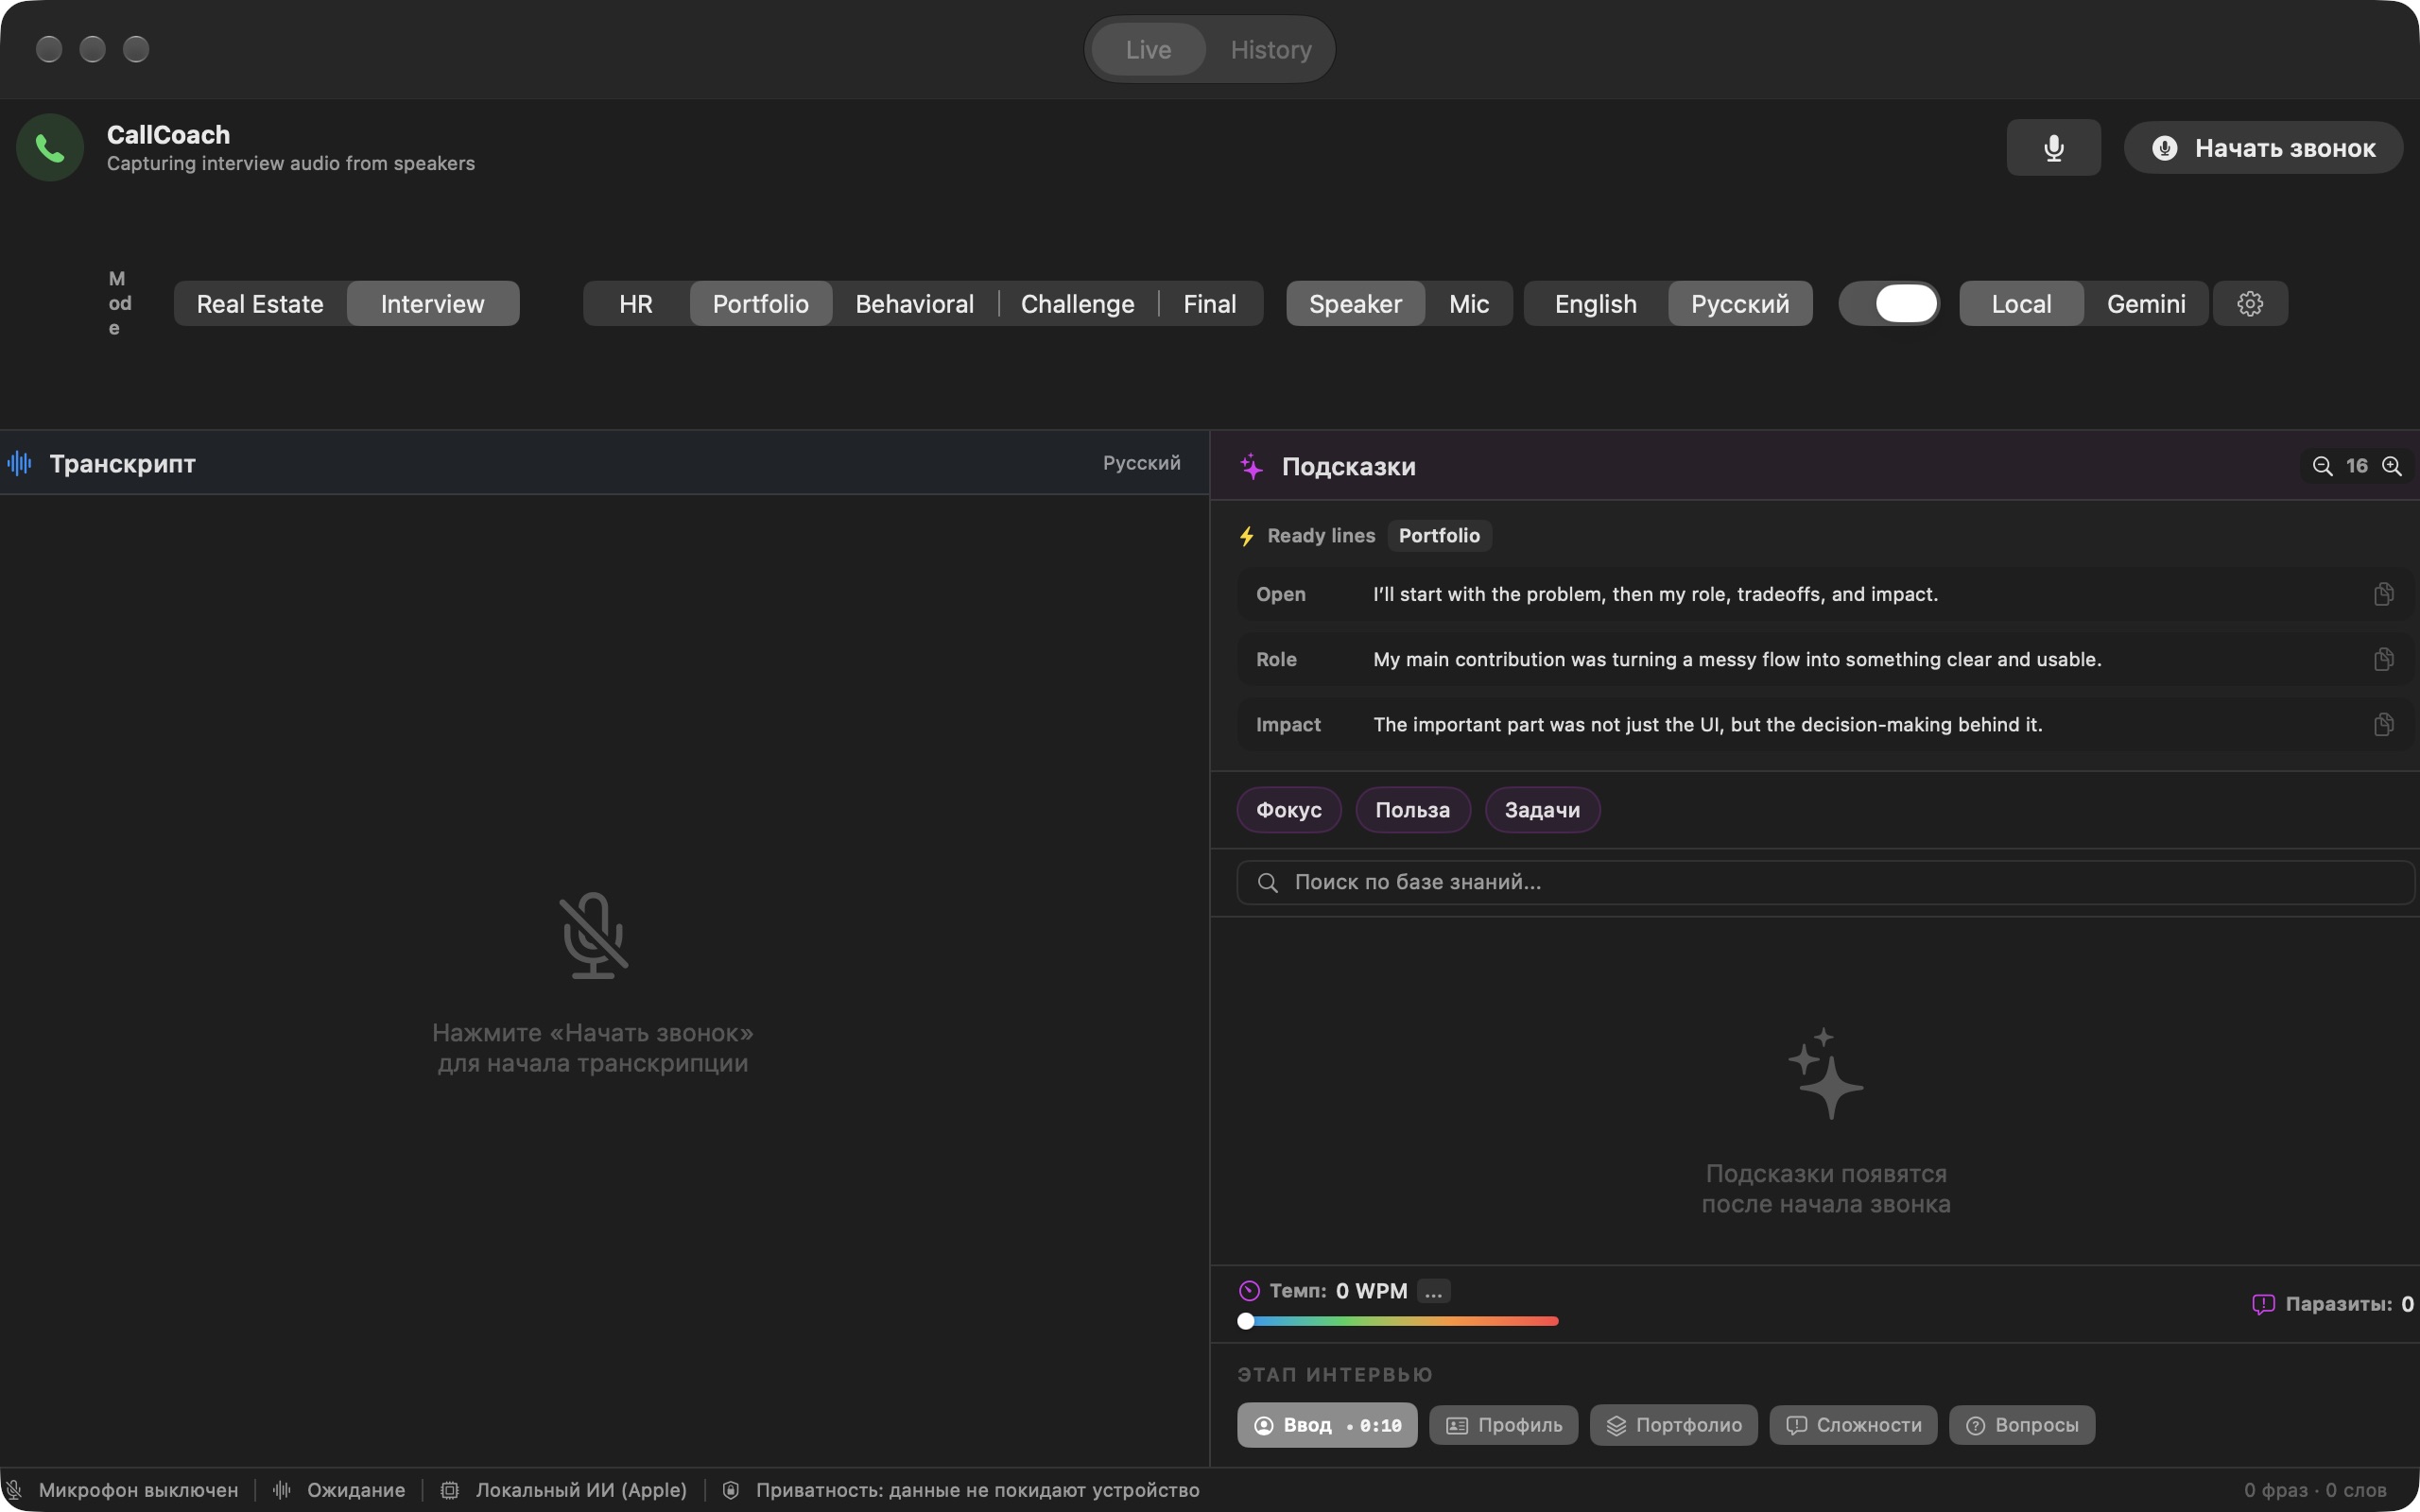
Im Interview-Modus hilft dieselbe Oberfläche bei der Vorbereitung auf ein Bewerbungsgespräch. Portfolio ist ausgewählt: kurze Vorlagen zu Aufgabe, eigener Rolle und Ergebnis sind sichtbar. Es ist das echte Anwendungsfenster ohne Gesprächsaufnahme.
„Kennt mein Thema“ heißt nicht „Ich habe das Modell trainiert“
Das Projekt enthält Gesprächsszenarien, Kontrollpunkte und die Auswahl relevanter Wissensfragmente. Das ist Kontextübergabe und Suche, kein Training der Modellgewichte. Der Unterschied zählt: Ein neues Dokument kann helfen, macht das System aber nicht zum geprüften Experten.
Die lokale Generierung nutzt Foundation Models nach einer Verfügbarkeitsprüfung auf dem Gerät. Im Code gibt es außerdem den umschaltbaren Cloud-Modus Gemini Live. Er ist standardmäßig aus, führt Audio bei Aktivierung jedoch anders. „Alles bleibt immer auf dem Mac“ wäre deshalb ein falsches Versprechen.
Das Schwierigste liegt auf dem Bildschirm
Ein Hinweis kann richtig sein und trotzdem stören: zu spät kommen, Offensichtliches wiederholen, Wichtiges verdecken oder zu viel Lesen verlangen. Dafür braucht es Tests in echten Gesprächen auf konkreter Hardware. Das Repository beweist keine Erkennungsqualität und bescheinigt keine Gesprächskompetenz.
Die Screenshots zeigen das echte Fenster und Vorschauen vorbereiteter Sätze. Sie zeigen den Oberflächenaufbau, nicht die Erkennungsqualität im echten Gespräch. Als Nächstes sind Zeitpunkt und Nutzen kurzer Hinweise auf bestimmter Hardware zu prüfen.
Verwandte Beiträge: Dialogorientiertes Portfolio.
@nevsky_alexander
Auf Instagram: Dubai jenseits der Postkarte — Familie, Stadt, Entdeckungen und das Leben zwischen den Projekten. Auf Threads: laute Gedanken über Design und KI. Auf YouTube: Videos, die mehr Platz brauchen als eine Story. Folgt mir dort, wo ihr euch wohlfühlt, und lasst uns in Kontakt bleiben