J’y écris sur le design, le travail avec l’IA, les produits numériques, l’immobilier et la vie de famille à Dubaï. J’ai besoin d’un site où tout cela puisse cohabiter : articles, photographies, projets professionnels et outils interactifs.
Au départ, il y avait Framer
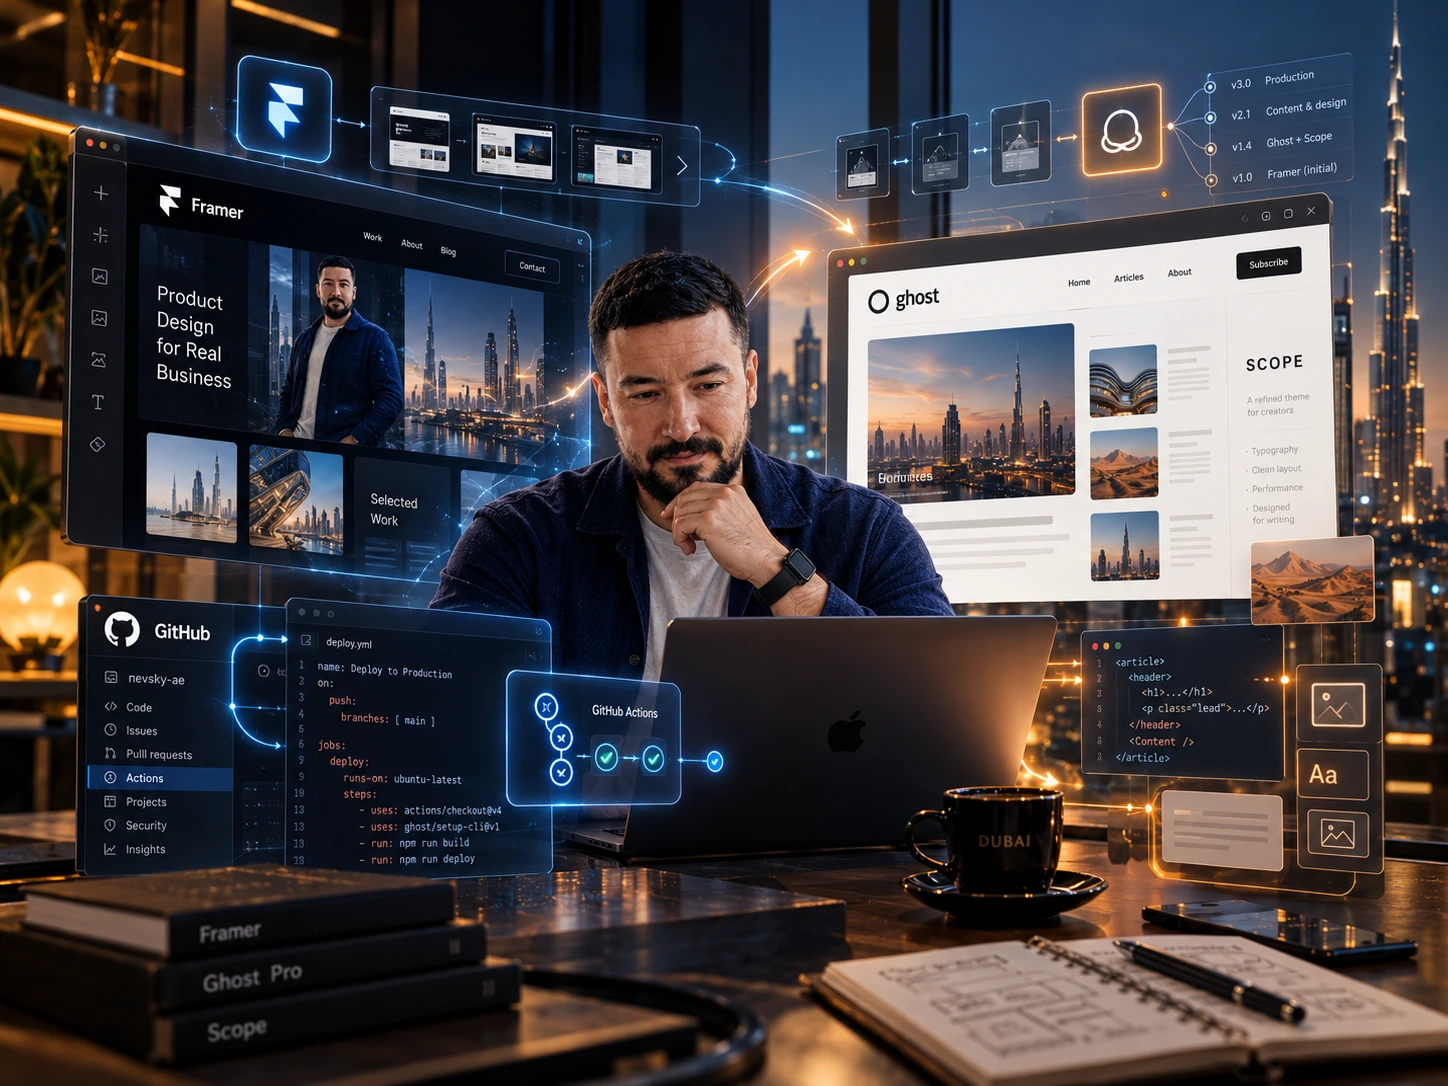
J’ai créé mon premier site sur Framer. Il est toujours accessible sur nevskii.me et me sert de portfolio de designer produit.
J’ai ensuite lancé un blog séparé sur Ghost Pro. J’ai acheté le thème Scope chez Priority Vision et commencé à le modifier. Je travaillais sur le thème via GitHub et GitHub Actions. En parallèle, j’écrivais et accumulais des contenus, avec un abonnement Ghost Pro à 35 dollars par mois.
Au fil du temps, le site a acquis son propre design et son historique de modifications. Je voulais conserver tout cela lors du déménagement suivant.
Pourquoi je suis passé à Astro
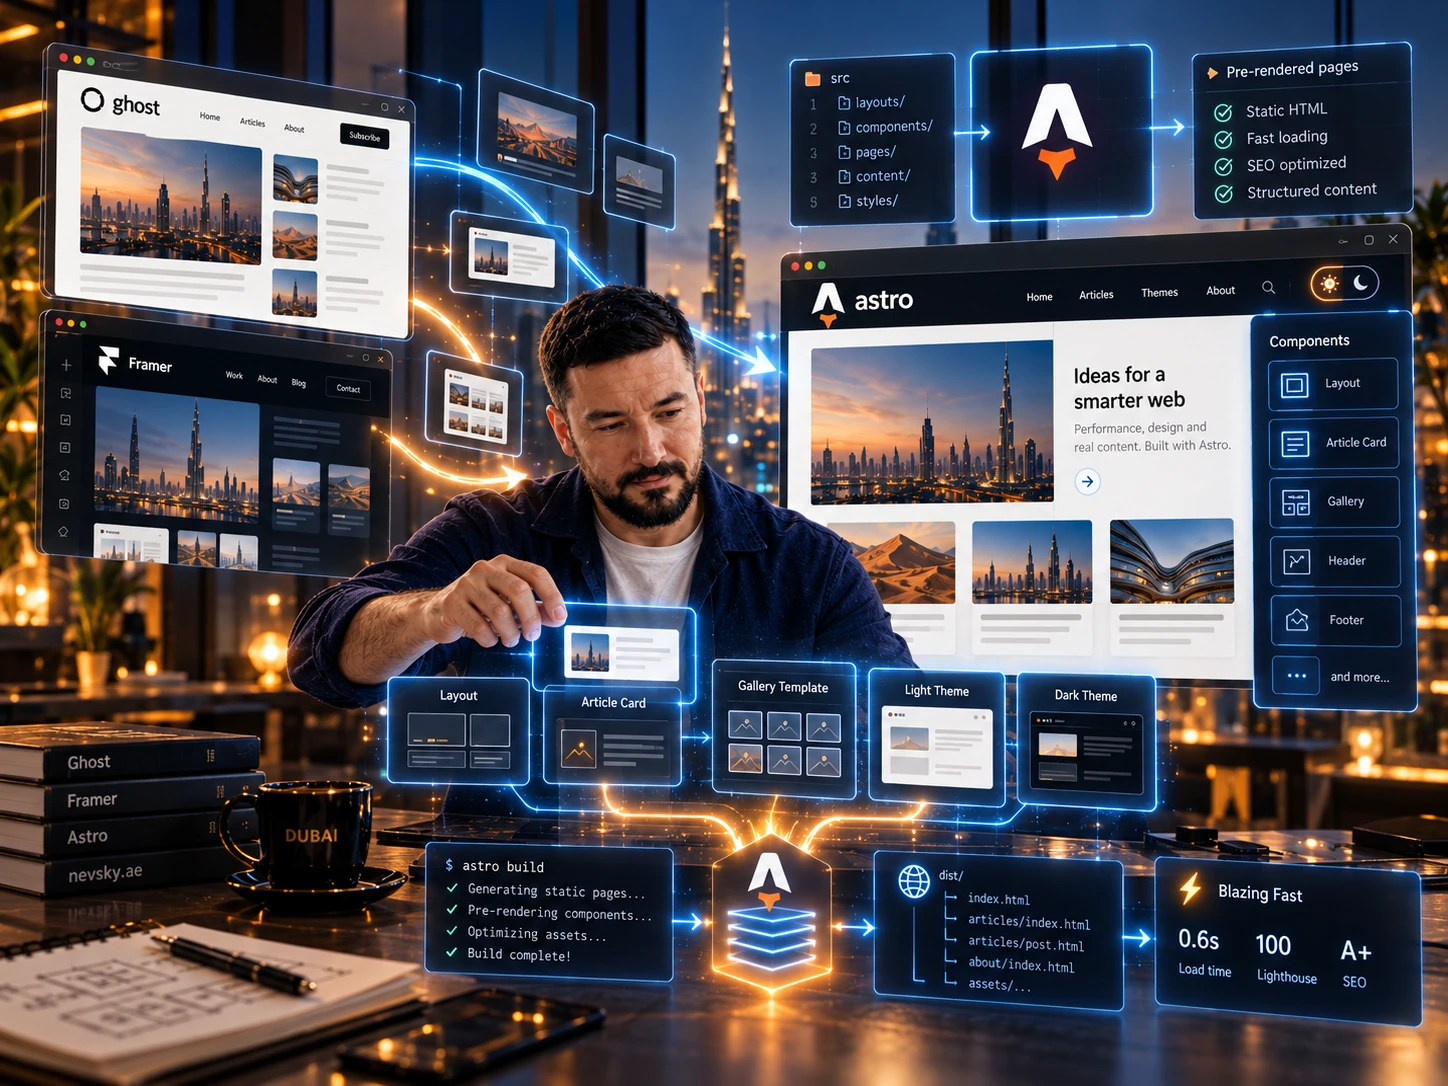
À un moment, j’ai décidé qu’il serait plus simple de construire le site avec Astro. J’ai porté le design du thème et continué à le faire évoluer dans le code.
Astro assemble les pages à partir de composants et peut produire le HTML à l’avance. Ce fonctionnement convient à un blog : le texte d’un article, les photographies et la navigation peuvent arriver dans le navigateur avec leur mise en page déjà prête. Le lecteur n’a pas à attendre que JavaScript construise la page sur son appareil.
Le transfert a demandé de porter les modèles d’articles, les listes de publications, les galeries, les menus et les thèmes clair et sombre. Les pages peuvent avoir des compositions différentes. Un article photographique et un fil de notes ne sont pas obligés de se ressembler.
L’apparence du blog repose toujours sur Scope, mais ses modèles fonctionnent désormais dans Astro. Framer reste un portfolio séparé et l’une des références visuelles.
Puis EmDash est arrivé
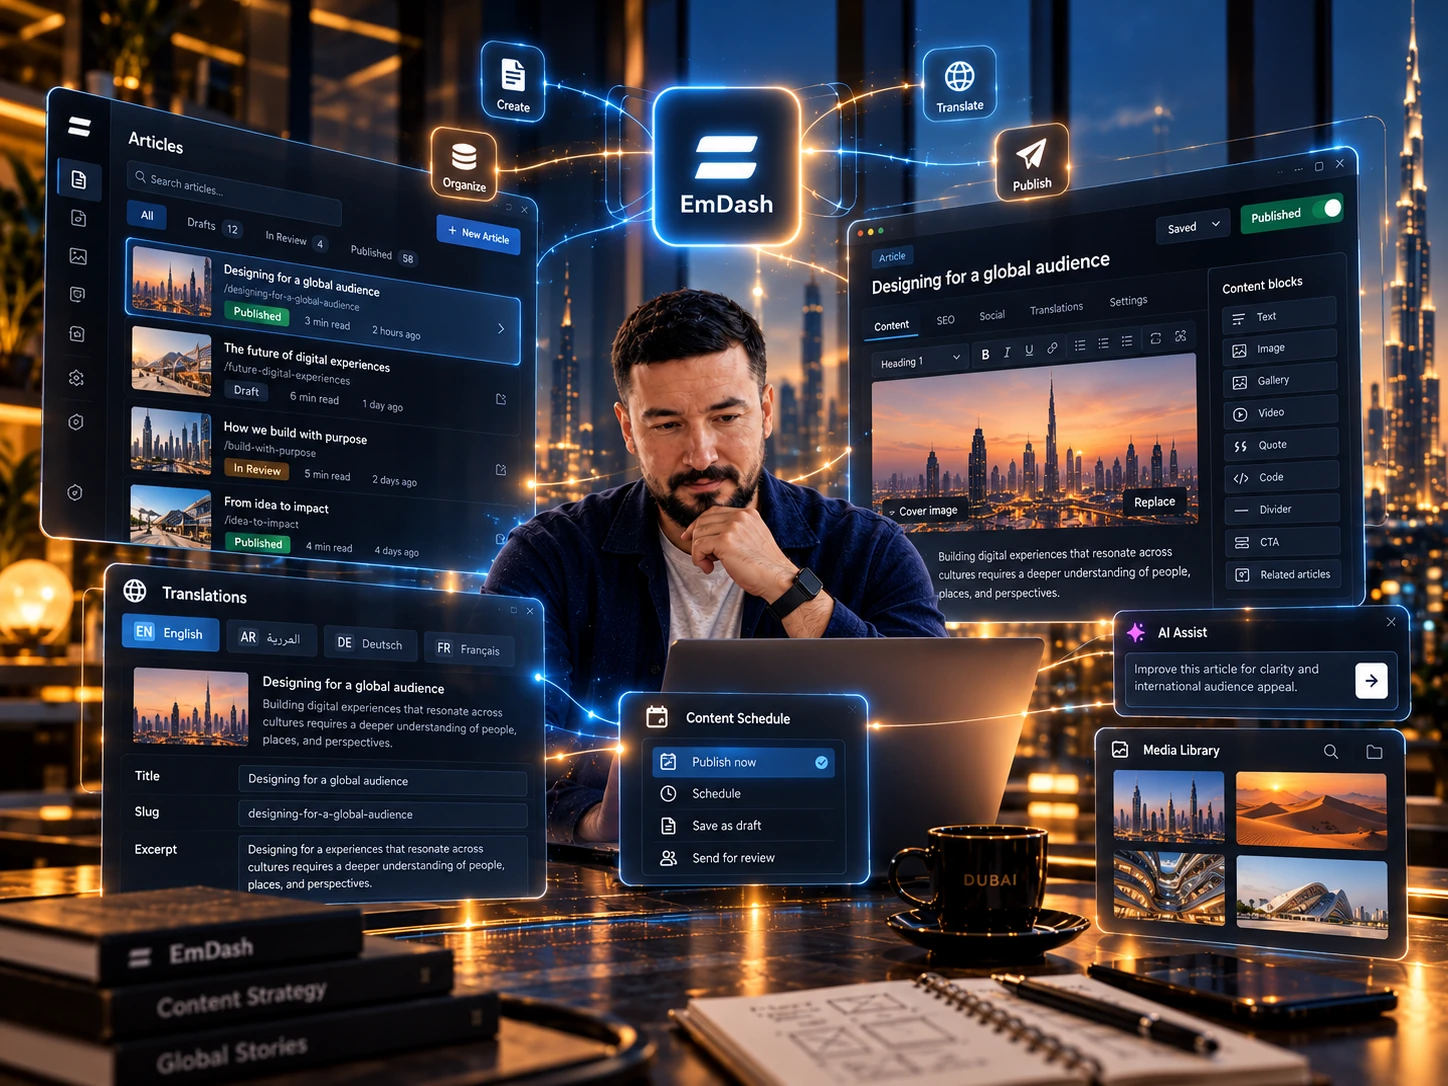
Quand la première version d’EmDash est apparue, j’ai décidé d’y transférer tous les contenus. Nous poursuivons encore ce transfert et le développement du site.
EmDash tient le rôle de CMS, le système de gestion des contenus du site. J’y travaille sur les articles, les pages et leurs traductions, et j’y modifie les légendes des images et les textes communs de l’interface. Les contenus disposent de brouillons et de versions publiées.
Le code et les contenus sont séparés. Les composants Astro déterminent comment afficher un article ou une galerie. EmDash en stocke le contenu. Modifier un paragraphe ne demande donc pas de le chercher dans les fichiers des modèles, et changer la présentation ne doit pas créer une copie supplémentaire de l’article.
Comment les éléments sont reliés
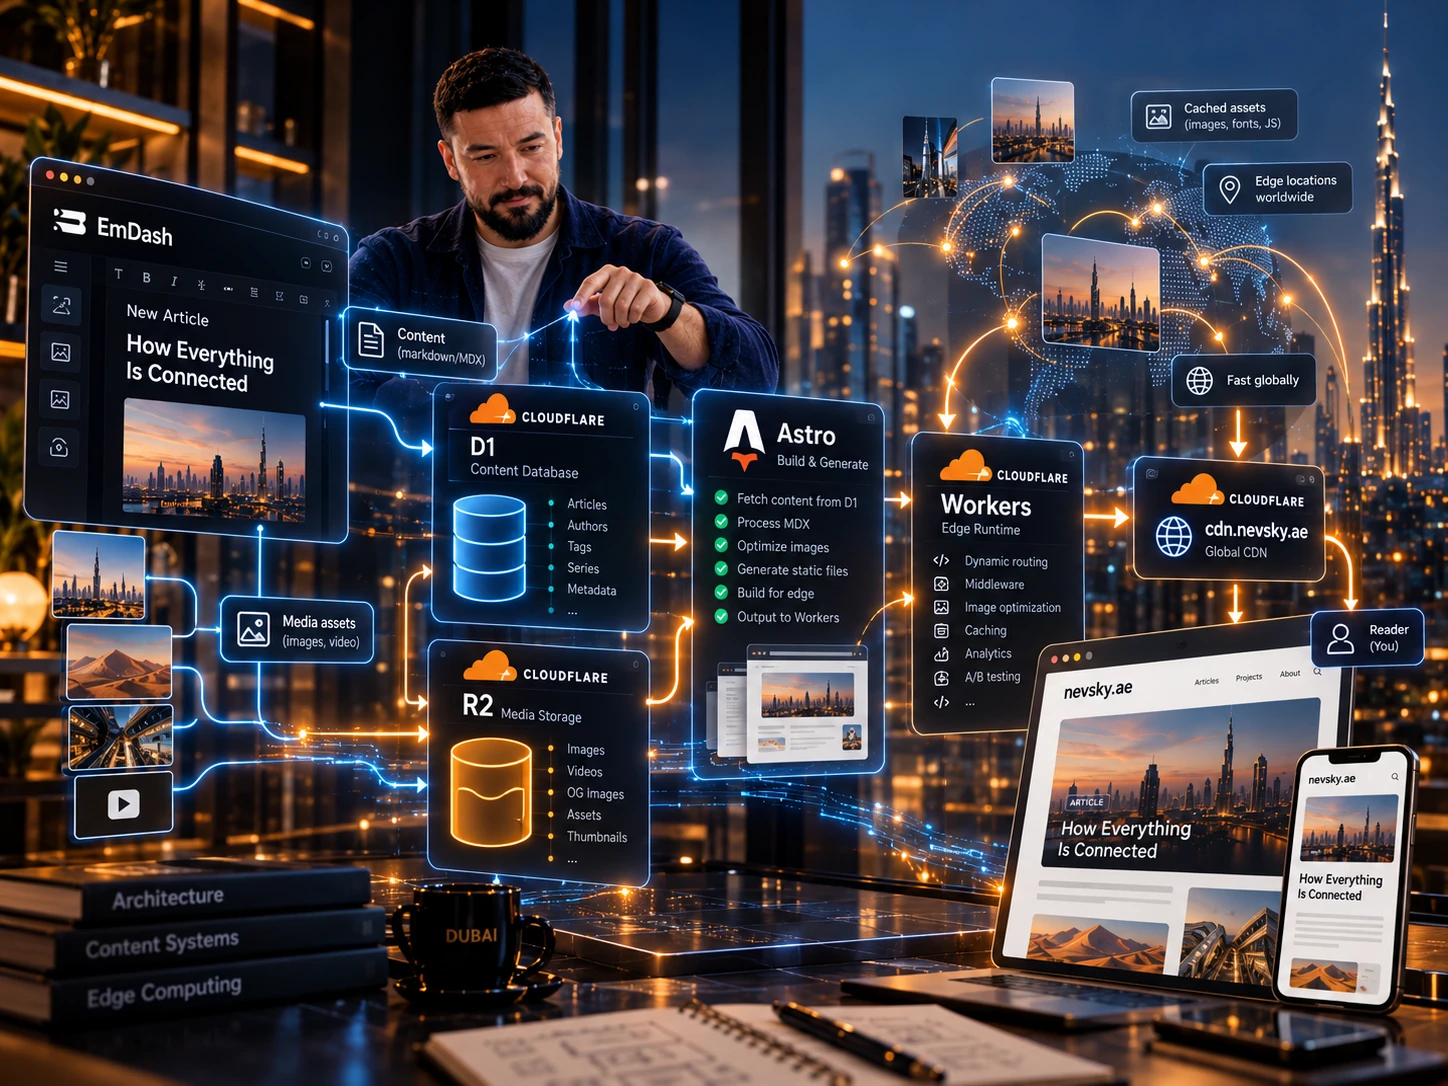
Le site comprend un éditeur, une étape de génération et une version publique.
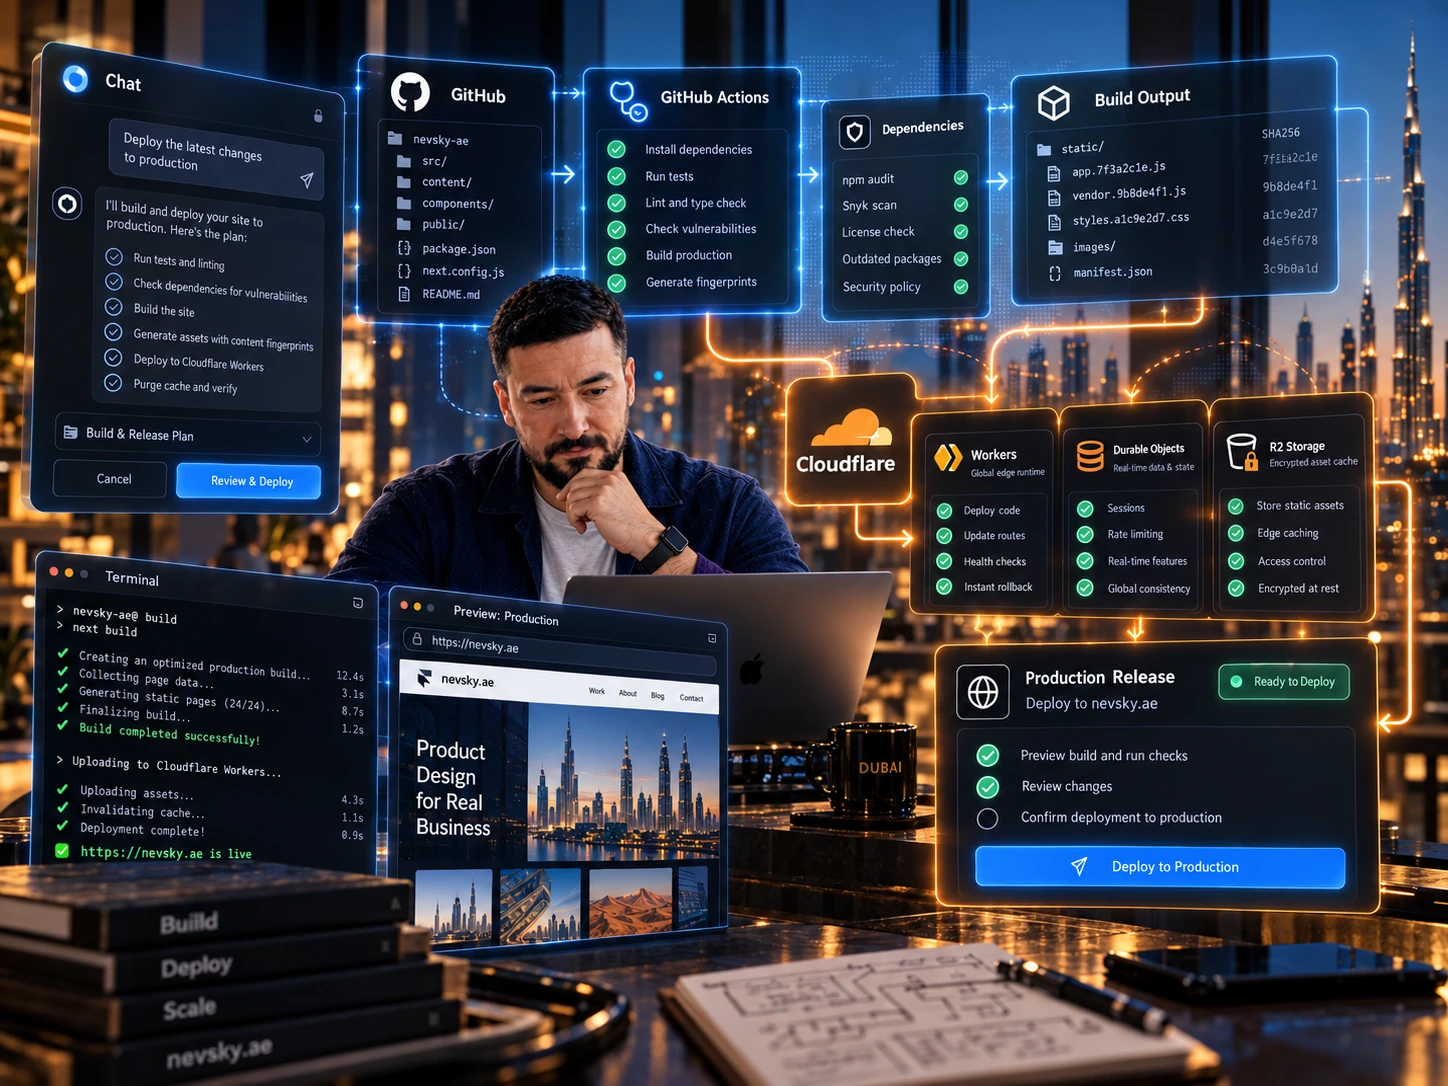
Je modifie les contenus dans l’éditeur EmDash. Les textes et les informations de publication sont stockés dans la base de données Cloudflare D1. Les médias importés utilisent le stockage objet Cloudflare R2 : les photographies et les autres fichiers sont conservés séparément du code du site.
Pour chaque mise en ligne, Astro reçoit un instantané des contenus publiés et génère les pages. Les liens vers les traductions, le plan du site et l’index de recherche sont préparés en même temps. Les brouillons sont exclus de cette génération.
Le site généré fonctionne sur Cloudflare Workers et est distribué par l’infrastructure Cloudflare. Une page d’article ordinaire ne contacte pas l’éditeur ou la base de données à chaque ouverture : son HTML est déjà prêt. La recherche utilise l’index de la même version publiée.
Un contenu suit ce chemin :
EmDash → version publiée dans D1 → génération Astro → Cloudflare → lecteurLes images sont préparées séparément. Les originaux sont conservés, et des variantes de taille adaptée sont créées pour les pages. Elles sont distribuées via cdn.nevsky.ae, afin qu’une petite carte, par exemple, n’ait pas à charger une photographie en pleine résolution.
La génération peut réutiliser les pages et les ressources déjà vérifiées lorsque leurs dépendances n’ont pas changé. Une modification des composants communs ou de la structure du site peut nécessiter une régénération complète.
Où intervient Svelte
Le projet utilise Svelte pour les interactions plus complexes. Il sert à la recherche et au filtrage du fil dans certaines présentations : on peut modifier une requête ou une catégorie, actualiser les résultats et conserver les paramètres choisis dans l’adresse de la page.
Astro permet d’ajouter ces composants individuellement. Un article reste une page HTML ordinaire, tandis qu’un bloc interactif reçoit son propre JavaScript à l’endroit où il est nécessaire. Svelte n’est pas chargé sur toutes les pages du blog principal.
Les menus, le changement de thème et les autres petits éléments peuvent fonctionner avec du JavaScript standard. Ils n’ont pas besoin d’un composant Svelte distinct.
Un contenu en sept langues
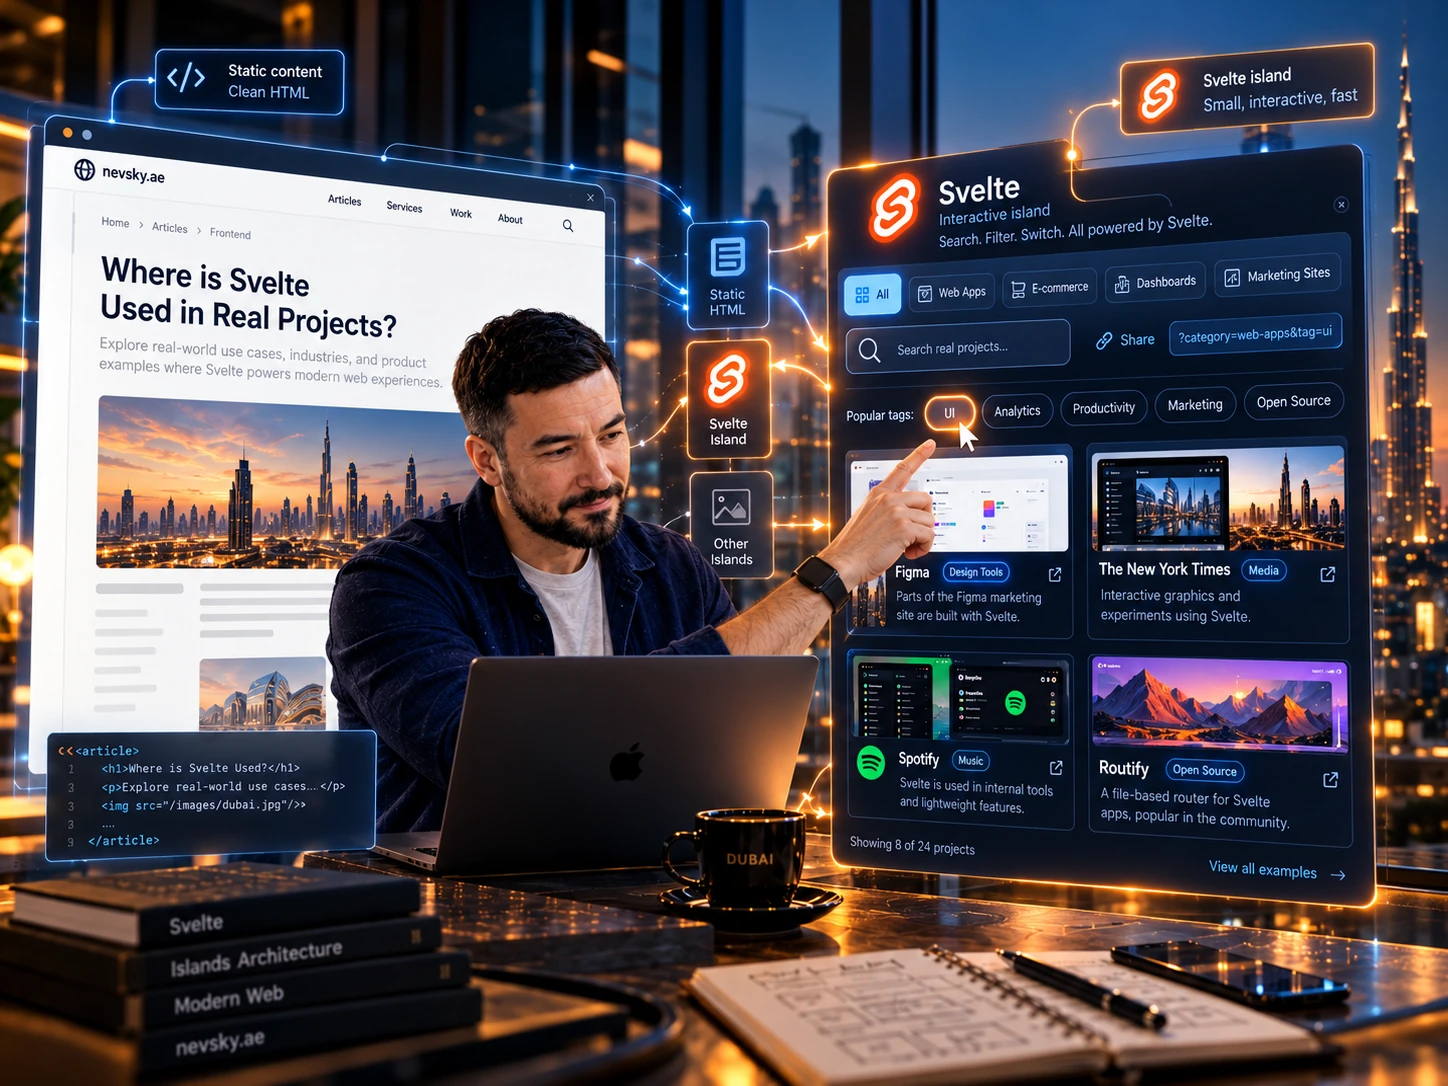
Le site prend en charge le russe, l’anglais, l’arabe, le chinois, le français, l’allemand et l’espagnol. Le russe est la langue source des contenus.
Dans EmDash, un article est stocké dans un seul document. Il possède une séquence commune de blocs et d’images, avec des versions linguistiques pour le texte, les titres, les légendes et les champs SEO.
Les traductions restent ainsi liées. Quand je change l’ordre des photographies, je n’ai pas à répéter manuellement la même opération dans sept articles séparés. Chaque version linguistique peut néanmoins avoir sa propre adresse et son propre statut de publication.
Les pages comportent des liens vers les traductions correspondantes et un balisage hreflang pour les moteurs de recherche. La version arabe tient compte de l’écriture de droite à gauche. Lorsqu’une traduction est publiée, le sélecteur de langue mène à cette version du contenu en cours.
Design et code
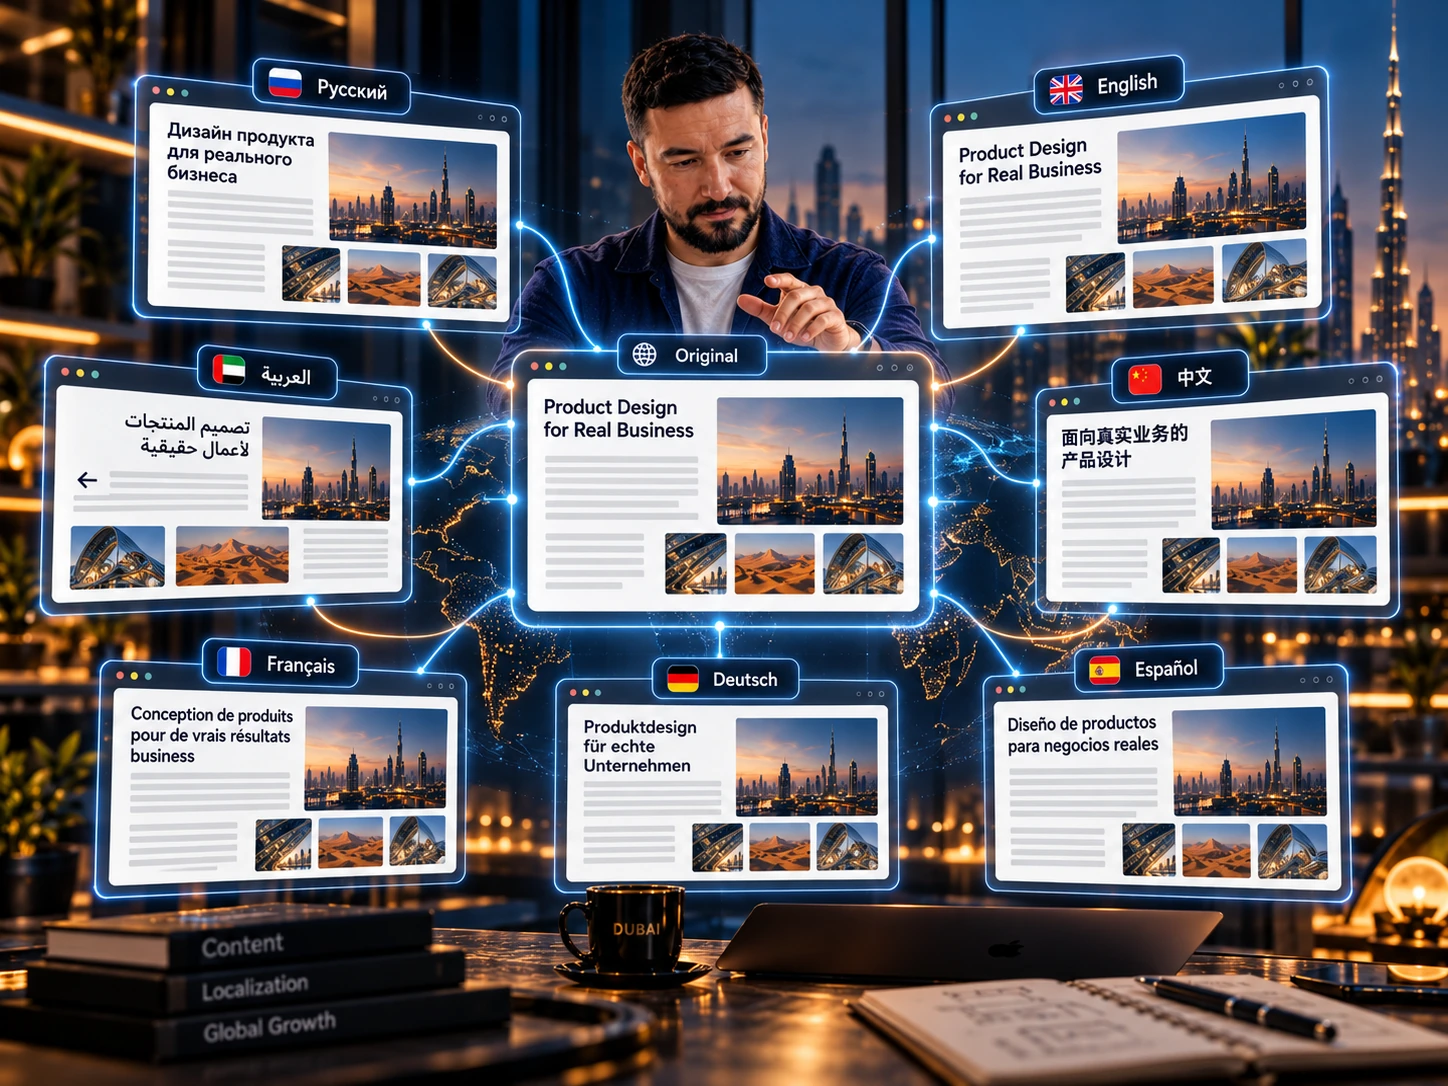
La typographie et la structure de Scope restent à la base de la présentation. Les couleurs communes, les boutons et les autres éléments récurrents sont décrits dans le système de design.
La couleur d’accent principale est actuellement #46a758. Le site utilise les polices Geist et Geist Mono servies localement, des thèmes clair et sombre et les icônes Remix Icon. Les styles sont écrits en CSS standard.
La palette et les exemples de composants sont regroupés sur la page publique du système de design. Les règles techniques et les tokens sont décrits dans design.md, pour que les nouvelles pages utilisent les mêmes couleurs, dimensions et états de boutons.
La stack technique en octobre 2026
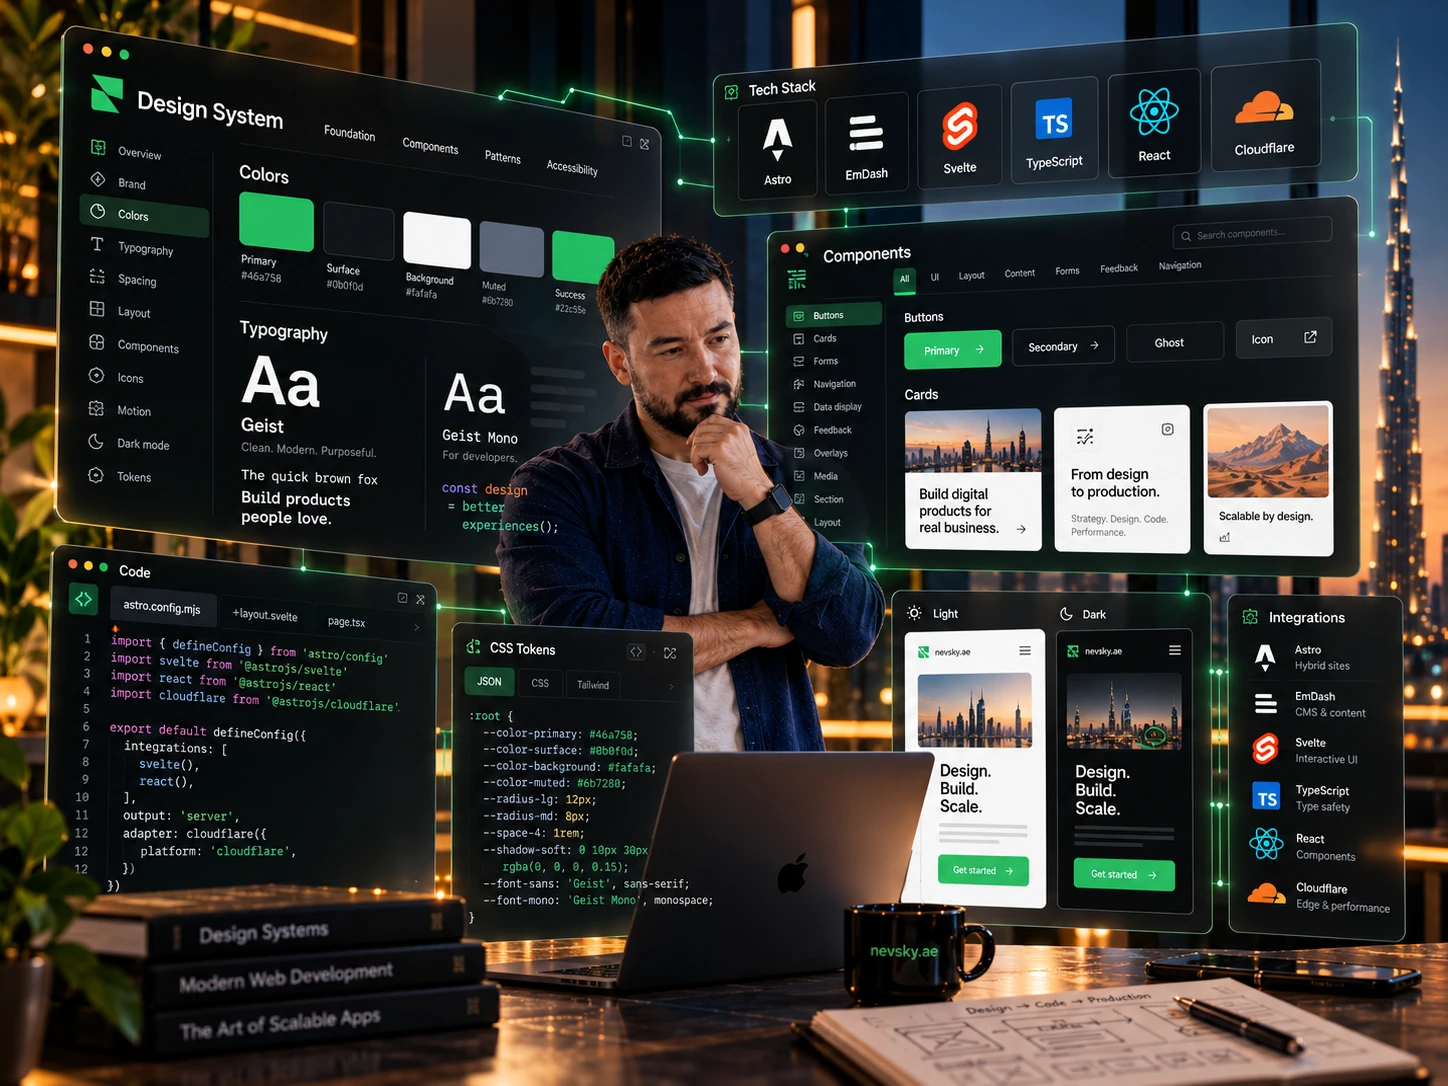
Le projet repose sur Astro 7.3.8 et EmDash 1.2.0. Les vues interactives complexes utilisent Svelte 5.57.1, avec TypeScript 6.0.3 comme langage applicatif. L’intégration Cloudflare passe par @astrojs/cloudflare 14.3.4. L’éditeur EmDash utilise React 19.2.4 ; son mode d’édition du texte entier repose sur Ghost Koenig et Lexical. Ce sont les versions des dépendances du projet au 19 octobre 2026.
Chaque couche a son rôle. Astro gère le HTML et les modèles, EmDash les contenus éditoriaux et leurs révisions, Svelte les composants interactifs. Cloudflare Workers exécute le code serveur, D1 stocke les données éditoriales et R2 les médias et les paquets de build privés. Le design utilise du CSS classique : variables, grilles adaptatives, états des composants et compositions de pages distinctes.
Pourquoi cette stack
Une grande partie du contenu du blog est connue avant la requête du lecteur. Titres, articles, photos et listes de publications peuvent être générés à l’avance. Le site principal sert donc du HTML statique depuis Cloudflare Workers Assets. Son environnement public n’a pas de connexion D1 : la base sert à l’éditeur et au build, lire un article ne lance aucune requête vers le CMS.
Astro permet aussi de construire des interfaces complexes. Dans des vues distinctes, des composants Svelte pilotent les flux interactifs et les paramètres d’affichage. Les articles ordinaires n’ont pas besoin d’hydratation. La recherche, les menus et le changement de thème disposent de petits scripts dédiés. Je peux ainsi choisir l’outil selon le comportement du bloc et contrôler la quantité de JavaScript reçue par le lecteur.
Le document éditorial comme modèle de données
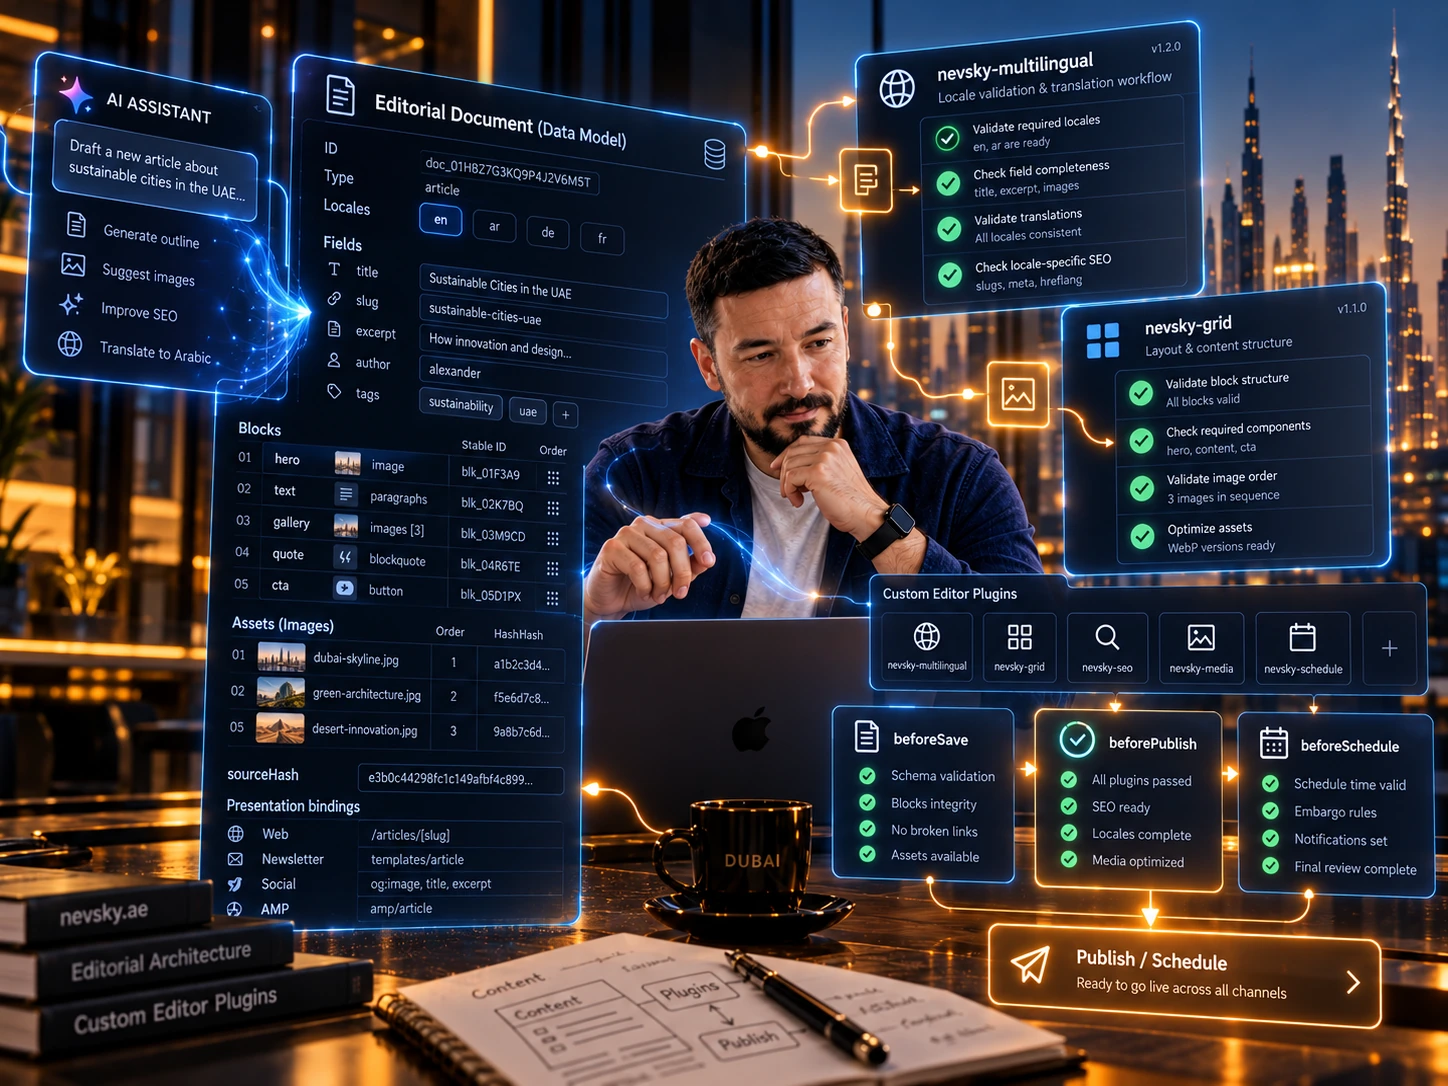
Un contenu EmDash comprend locales, fields, un tableau blocks commun et presentation avec les associations de mise en page. Chaque bloc possède un ID stable, une structure et des médias communs ; ses textes sont répartis dans des cellules linguistiques. Une galerie partage l’ordre des images, tandis que légendes et textes alt sont localisés. Déplacer une photo modifie une seule structure pour toutes les traductions.
Le russe est la langue source. Les versions anglaise, arabe, chinoise, française, allemande et espagnole se trouvent dans le même document. Chacune a son chemin et son statut de publication. Une modification de la source peut signaler une traduction périmée via sourceHash. L’import vérifie les ID, le hachage de la source et le nombre de fragments de texte, pour qu’une réponse du modèle ne restructure pas le contenu ou ne perde pas une image.
Les libellés communs, menus et réglages appartiennent également à EmDash. Un contenu peut référencer des champs appartenant à un autre document. La vue publique résout ces références depuis les documents publiés. Un même libellé ne devient donc pas sept copies modifiables séparément, et changer la navigation ne demande pas de chercher du texte dans les modèles.
Des plugins d’édition maison
J’ai créé le plugin natif nevsky-multilingual 1.0.0 pour ce modèle. Il connecte l’éditeur et les contrôles beforeSave, beforePublish et beforeSchedule. Il vérifie la structure du document, les versions linguistiques, les chemins et les données obligatoires. Les traductions sont ajoutées à l’intérieur du contenu. Publier ou retirer une publication envoie un signal au système de mise en ligne.
Le mode texte entier utilise l’éditeur Ghost Koenig. Le mode blocs reste disponible à côté ; tous deux modifient le même document. Un plugin distinct, nevsky-grid 0.1.0, relie contenu et mise en page : il vérifie à quel contenu appartient la composition, les références aux blocs et la révision du layout. Changer l’agencement conserve la source éditoriale.
L’IA aide à préparer textes et traductions, les plugins contrôlent le résultat avant enregistrement et publication. Je peux préparer un texte dans un projet ou un chat ChatGPT, le relire selon nos règles humanizer et le transférer dans un contenu multilingue unique. Le fournisseur IA de traduction côté serveur n’est pas configuré actuellement : le processus utilise une traduction préparée et vérifiée.
Comment fonctionnent les builds et les mises en ligne
Le build lit uniquement les révisions natives publiées via live_revision_id et les relations publiées avec catégories, tags et auteurs. Les brouillons restent hors de l’export. Avant une mise en ligne, la version des sources et l’empreinte des données publiées sont enregistrées. Si quelqu’un publie un contenu ou modifie le code pendant le build, un nouveau contrôle arrête la livraison devenue obsolète.
Pour les builds suivants, j’ai développé un suivi des dépendances par page. Pendant le rendu, l’adaptateur enregistre les requêtes SQL, leurs paramètres et les hachages des résultats. Au build suivant, il les exécute sur un nouveau snapshot : un résultat différent exige un nouveau rendu de la page. Le HTML inchangé peut être réutilisé. Le suivi couvre la composition et l’ordre des flux, les résultats vides, les auteurs, les champs communs et les cartes liées. Un changement de code, de dépendances, d’environnement ou d’inventaire des routes entraîne une reconstruction complète.
Le résultat forme un paquet complet comprenant HTML, index de recherche, styles, médias et fichiers lisibles par les machines. Le paquet est contrôlé localement, puis une nouvelle version du Worker est chargée. Les URL publiques et les métadonnées de livraison sont vérifiées ensuite. Un échec peut déclencher un retour à la version précédente. Sources et données publiées sont revérifiées juste avant le chargement.
Cloudflare, builds cloud et travail depuis le chat
L’éditeur, D1, R2 et la diffusion publique fonctionnent déjà sur Cloudflare ; le code est sur GitHub. Un publisher privé fondé sur Workers et Durable Objects est prêt pour les builds cloud. Il reçoit les événements EmDash, regroupe les publications rapprochées et peut lancer un build vérifié via GitHub Actions. J’ai actuellement désactivé le lancement automatique ; la production est publiée manuellement au terminal avec les mêmes contrôles.
Les paquets de build validés peuvent être conservés dans un cache R2 privé chiffré en AES-256-GCM. Un paquet contient la sortie générée, les dépendances et les sommes de contrôle. Brouillons, base CMS et secrets en sont exclus. Avant réutilisation, les sources, l’environnement et l’intégrité des fichiers sont comparés. Un tel paquet permet de poursuivre le build dans un autre environnement ; un nouvel OS ou une nouvelle version de l’outillage demande d’abord sa propre base complète.
Je déplace davantage de travail vers le cloud pour lancer des tâches depuis un projet ou un chat, sans dépendre d’un ordinateur de travail toujours allumé. Préparer un texte, modifier le code et mettre en ligne restent des actions distinctes. Une interface de dialogue a toujours besoin de brouillons, de contrôles des changements et d’une maîtrise de la publication.
Le SEO technique dans le build
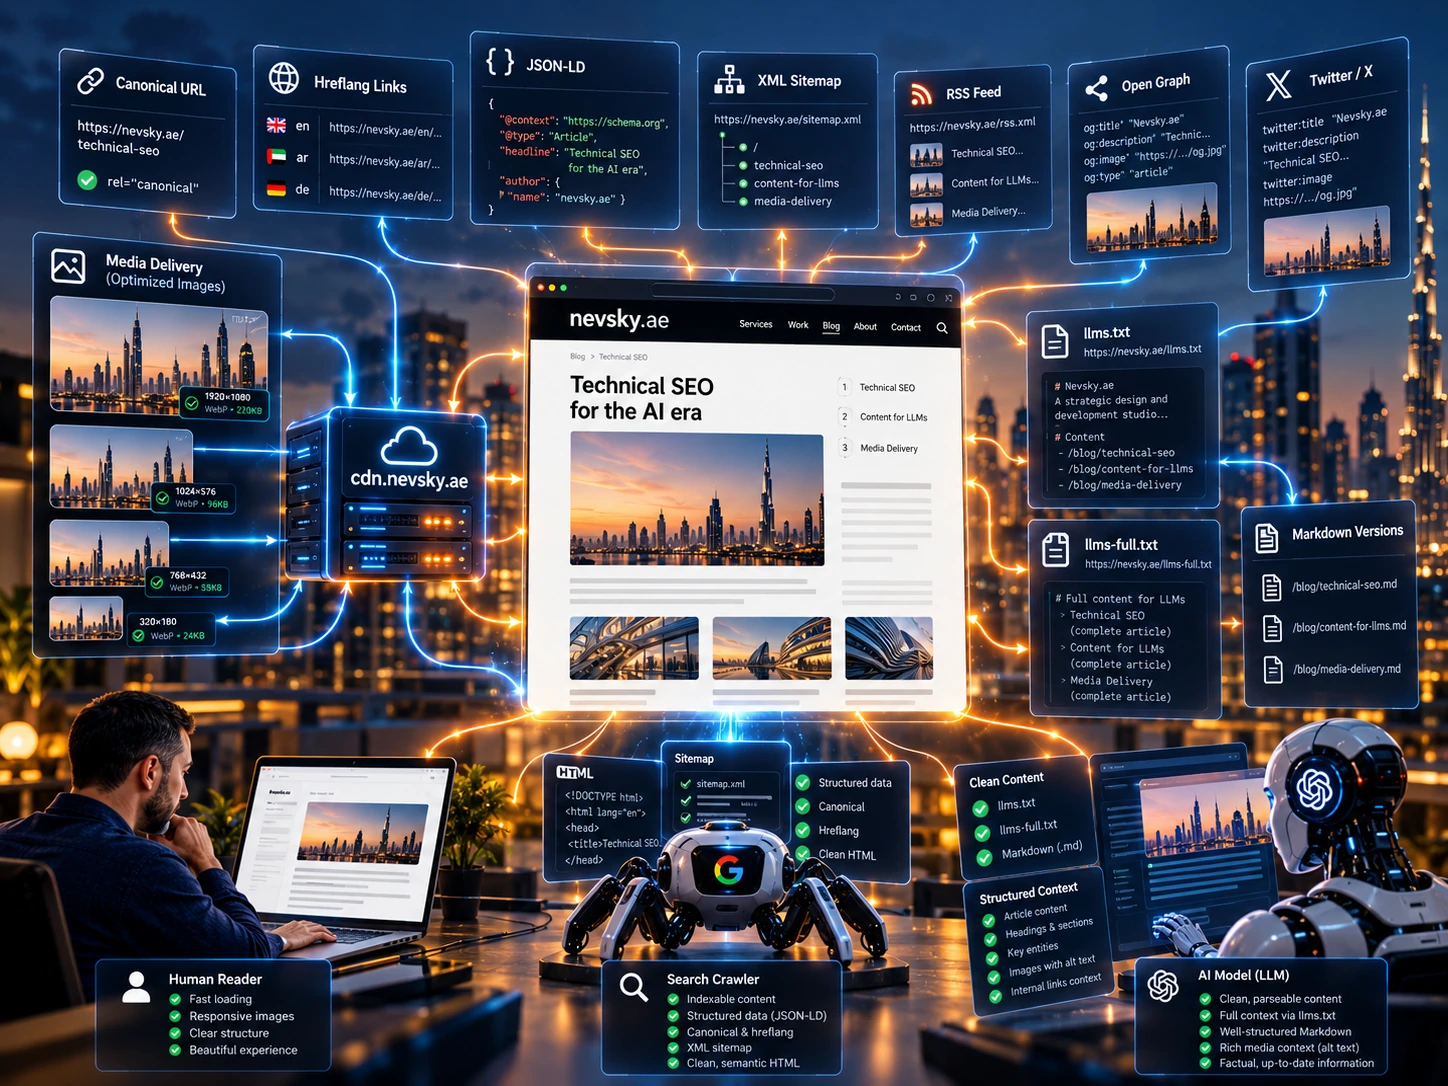
Chaque version linguistique publiée a son URL, son canonical, son lang et ses liens hreflang vers les traductions correspondantes. La langue par défaut possède x-default. Les pages arabes reçoivent dir="rtl". Titres, descriptions, métadonnées Open Graph et Twitter viennent du même document EmDash que le texte visible.
JSON-LD décrit WebSite et le type précis de page : BlogPosting pour un article, ProfilePage pour un auteur, CollectionPage pour une collection et WebPage pour une page ordinaire. Auteurs et dates viennent des données éditoriales. Les sitemaps sont séparés par type de contenu ; le RSS provient des contenus publiés. Les contrôles du build parcourent tout le graphe des liens internes, canonical, hreflang et URL de sitemap, au-delà de la présence de quelques balises meta.
Du contenu pour les LLM
Les contenus publiés produisent automatiquement des versions Markdown des pages, ainsi que llms.txt et llms-full.txt en sept langues. Le fichier court donne le profil, les langues et des liens vers les contenus ; le fichier complet contient une sortie textuelle étendue. La version destinée aux machines partage la source éditoriale du site. Je ne tiens pas de biographie séparée pour les robots.
Les outils IA reçoivent un texte avec titres, liens et URL sources, lisible sans analyser l’interface de la page. La préparation d’une mise en ligne actualise l’ensemble des fichiers associés. C’est là que se rejoignent pour moi rédaction, SEO et IA : un contenu mérite une présentation soignée pour une personne, un moteur de recherche et un modèle.
Livraison des médias et contrôle des changements
Les médias sont servis séparément du HTML. Le build choisit les variantes d’images adaptatives, conserve les liens vers les originaux et vérifie les fichiers dérivés. Là où une optimisation sans perte s’applique, les pixels décodés sont comparés. La couverture des caractères des polices locales Geist et Geist Mono est préparée ; un caractère absent passe par une police système. Remix Icon utilise des masques CSS locaux.
Les modifications passent par des contrôles de types, des tests du modèle et de la publication, les builds des vues, des audits de dépendances et des scénarios navigateur. La version publiée est contrôlée séparément : un build local réussi ne prouve pas que le bon HTML, la police et la traduction sont arrivés à l’URL publique. Chaque livraison conserve sa version de source, l’empreinte du contenu et les résultats des contrôles.
Comment je poursuis le travail
Je modifie les contenus dans EmDash et conserve le code sur GitHub. J’utilise des outils d’IA pour travailler sur le code ; les modifications sont vérifiées par des compilations, des tests et des contrôles dans le navigateur. GitHub Actions faisait déjà partie du travail sur le thème Ghost. Le projet actuel dispose aussi d’une procédure de mise en ligne depuis le terminal, avec des vérifications avant le transfert et après le déploiement.
Enregistrer un texte crée un brouillon. La publication dans EmDash et la mise en ligne d’une nouvelle version du site sont deux étapes distinctes. Pour le moment, les mises en ligne du site sont lancées manuellement après vérification.
Le transfert se poursuit. Les publications en sept langues, la bibliothèque commune de contenus et plusieurs façons de les présenter fonctionnent déjà. Je continue à développer l’éditeur, le design et les pages interactives sur cette base.
Ce que je peux construire sur cette base
Je peux concevoir et développer un site de ce type pour un auteur, un studio ou une entreprise : migrer les contenus d’un ancien CMS, conserver les URL, configurer plusieurs langues et adapter l’éditeur au vrai travail éditorial. Pour un catalogue ou une présentation complexe, on peut ajouter des composants interactifs et des compositions de pages sur mesure.
Ce travail réunit mon expérience en design produit et le développement assisté par l’IA. Je peux prendre en charge tout le parcours : structurer les contenus, construire l’interface, écrire les plugins éditoriaux, configurer la diffusion cloud et vérifier le résultat publié. Si vous avez besoin d’un tel site, écrivez-moi sur Telegram et montrez-moi ce que vous voulez publier et comment vous comptez travailler avec.
@nevsky_alexander
Sur Instagram, Dubaï au-delà de la carte postale : la famille, la ville, les trouvailles et la vie entre deux projets. Sur Threads, des réflexions à voix haute sur le design et l’IA. Sur YouTube, des vidéos qui ont besoin de plus de place qu’une story. Retrouvez-moi là où vous vous sentez bien, et gardons le contact